Questão de Programação — Linguagens de programação — CESPE / CEBRASPE 2024
Programação›Linguagens de programação
Código
ce185166
Banca
CESPE / CEBRASPE
Órgão
SEBRAE-NACIONAL
Ano
2024
Nível
Superior
Cargo
Analista Técnico II – Cientista de Dados
Assinale a opção correta a respeito da implantação de um modelo de classificação de árvore de decisão em Python.
APara treinar um modelo, deve-se utilizar o método , em que a variável representa os rótulos verdadeiros, e as características dos dados.
BApós treinar o modelo por meio do comando , o método deve ser utilizado para avaliar o desempenho do modelo com novos dados de teste.
CO método é utilizado para avaliar o desempenho do modelo de árvore de decisão aos dados de treinamento.
DApós treinar o modelo por meio do comando , deve-se utilizar para realizar previsões em novos dados de teste.
Revelar gabarito e comentário▾
GabaritoB — Após treinar o modelo por meio do comando [imagem], o método [imagem] deve ser utilizado para avaliar o desempenho do modelo com novos dados de teste.
Comentário gerado por IA. É um apoio ao estudo, ancorado em fontes, mas pode conter imprecisões — confira sempre na fonte oficial (lei, súmula, edital e gabarito da banca). Encontrou um erro? Use “Reportar”.
Árvore de decisão em Python: treino, avaliação e previsão
Gabarito: letra B. Após treinar o modelo com o método fit(), o método score() é o mais adequado para avaliar o desempenho com novos dados de teste, pois retorna a acurácia média do modelo nesses dados. As demais alternativas confundem os papéis dos métodos fit(), predict() e score() no fluxo de trabalho de aprendizado de máquina com a biblioteca scikit-learn. O fluxo de trabalho de um modelo de classificação com árvore de decisão em Python, tipicamente usando a biblioteca scikit-learn, segue uma sequência bem definida: primeiro, instancia-se o modelo (ex.: DecisionTreeClassifier()); depois, treina-se o modelo com o método fit(X, y), onde X são as características (features) e y os rótulos (target); em seguida, faz-se previsões com o método predict(X); e, por fim, avalia-se o desempenho com o método score(X, y), que retorna a acurácia média. A confusão entre esses métodos é o ponto central desta questão.
O método fit() é o responsável por ajustar o modelo aos dados de treinamento. Ele recebe dois argumentos: a matriz de características X e o vetor de rótulos y. Durante o treinamento, a árvore de decisão aprende as regras de classificação a partir dos dados fornecidos. Já o método predict() é usado para gerar previsões de classes para novos dados, após o modelo ter sido treinado. O método score() calcula a acurácia do modelo, ou seja, a proporção de previsões corretas, comparando as previsões com os rótulos verdadeiros. A pegadinha da banca está em inverter os papéis desses métodos. A alternativa B é a única que descreve corretamente o uso do score() para avaliar o desempenho com dados de teste. As demais alternativas ou usam o método errado para a tarefa, ou invertem os argumentos, ou atribuem ao score() a função de treinar o modelo. É fundamental memorizar o fluxo: fit() treina, predict() prevê, score() avalia.
1Instanciar modelo
2fit(X, y) treina
3predict(X) prevê
4score(X, y) avalia
LEVEL · soulevel.com.br
Alternativa A — ❌ Incorreta
O erro está na inversão dos argumentos do método fit(). A alternativa afirma que a variável imagem da questão representa os rótulos verdadeiros e imagem da questão as características, mas a ordem correta é fit(X, y), ou seja, primeiro as características (X) e depois os rótulos (y). A banca troca a ordem dos parâmetros, o que é um erro clássico.
Alternativa B — ✅ Correta ⟵ GABARITO
Esta alternativa descreve corretamente o uso do método score() para avaliar o desempenho do modelo com novos dados de teste. Após o treinamento com fit(), o método score(X_test, y_test) calcula a acurácia média do modelo, comparando as previsões com os rótulos verdadeiros do conjunto de teste. É exatamente essa a função do score().
Alternativa C — ❌ Incorreta
O erro está em atribuir ao método imagem da questão (que seria fit()) a função de avaliar o desempenho do modelo. O fit() é usado para treinar o modelo, não para avaliá-lo. A avaliação é feita com o score(). A alternativa confunde o método de treinamento com o de avaliação.
Alternativa D — ❌ Incorreta
O erro está em usar o método imagem da questão (que seria score()) para realizar previsões. O método correto para previsões é o predict(), não o score(). O score() é usado para avaliar o desempenho, enquanto o predict() é usado para gerar previsões em novos dados. A alternativa troca a função dos métodos. Gabarito: letra B
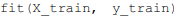 , em que a variável
 representa os rótulos verdadeiros, e
 as características dos dados.
 , o método
 deve ser utilizado para avaliar o desempenho do modelo com novos dados de teste.
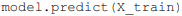 é utilizado para avaliar o desempenho do modelo de árvore de decisão aos dados de treinamento.
 , deve-se utilizar
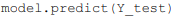 para realizar previsões em novos dados de teste.