Questão de Programação — Linguagens de programação — CESPE / CEBRASPE 2024
Programação›Linguagens de programação
Código
ce185170
Banca
CESPE / CEBRASPE
Órgão
SEBRAE-NACIONAL
Ano
2024
Nível
Superior
Cargo
Analista Técnico II – Cientista de Dados
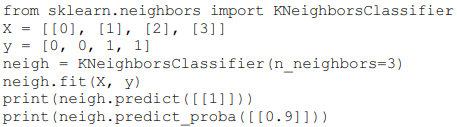
O seguinte código Python utiliza o algoritmo KNN (k-nearest neighbors) para classificação, em que o parâmetro define o número de vizinhos que o classificador KNN irá considerar para realizar a previsão.
Com base no código precedente, é correto afirmar que, caso o valor de fosse alterado de 3 para 4, o modelo
Anão seria capaz de classificar novos pontos de dados e retornaria
Bpoderia resultar em empates mais frequentes, levando a previsões que dependam mais do critério de desempate do algoritmo.
Cconsideraria todos os pontos de treinamento para qualquer nova previsão, o que levaria a resultados mais precisos.
Dpoderia fornecer previsões mais sensíveis a mudanças pequenas no dado, com menos probabilidade de empate.
Revelar gabarito e comentário▾
GabaritoB — poderia resultar em empates mais frequentes, levando a previsões que dependam mais do critério de desempate do algoritmo.
Comentário gerado por IA. É um apoio ao estudo, ancorado em fontes, mas pode conter imprecisões — confira sempre na fonte oficial (lei, súmula, edital e gabarito da banca). Encontrou um erro? Use “Reportar”.
Algoritmo KNN: impacto do parâmetro k
Gabarito: letra B. No algoritmo KNN (k-nearest neighbors), o parâmetro k define quantos vizinhos mais próximos são consultados para a classificação. Ao aumentar k de 3 para 4, o modelo passa a considerar um número par de vizinhos, o que pode resultar em empates mais frequentes na votação entre as classes, tornando a previsão mais dependente do critério de desempate adotado pela implementação.
O KNN é um algoritmo de aprendizado supervisionado usado para classificação e regressão. A ideia central é simples: para classificar um novo ponto, o algoritmo identifica os k pontos do conjunto de treinamento mais próximos dele (por alguma métrica de distância, como a euclidiana) e realiza uma "votação" entre esses vizinhos. A classe que tiver mais representantes entre os k vizinhos é atribuída ao novo ponto.
O valor de k é um hiperparâmetro crucial. Um k pequeno (como 1 ou 3) torna o modelo mais sensível a ruídos e a pontos isolados, pois a decisão depende de poucos vizinhos. Já um k grande (como 20 ou 50) suaviza a fronteira de decisão, tornando o modelo mais robusto a ruídos, mas pode suavizar demais e perder detalhes importantes da distribuição dos dados. A escolha de k é um equilíbrio entre viés e variância.
O ponto central desta questão é a paridade de k. Quando k é um número ímpar, em um problema de classificação binária (duas classes), é impossível haver empate na votação: sempre haverá uma classe com mais votos. Por exemplo, com k=3, as possibilidades de votação são 3-0 ou 2-1, nunca um empate. Quando k é par, como k=4, o empate é possível: a votação pode ser 2-2. Nesse caso, o algoritmo precisa de um critério de desempate, que varia conforme a implementação (por exemplo, escolher a classe do vizinho mais próximo, ou a classe com maior probabilidade estimada). Portanto, aumentar k de 3 para 4 introduz a possibilidade de empates, que antes não existiam.
A alternativa B captura exatamente esse efeito: com k=4, empates podem ocorrer, e a previsão passa a depender mais do critério de desempate do algoritmo. As demais alternativas apresentam consequências incorretas ou exageradas da mudança de k.
Guarde a distinção entre k ímpar e k par: é ela que separa a alternativa correta das incorretas. Em problemas binários, k ímpar evita empates; k par os possibilita.
1k ímpar (3)
2Sem empate em binário
3k par (4)
4Empate possível (2-2)
5Depende do desempate
LEVEL · soulevel.com.br
Alternativa A — ❌ Incorreta
Afirma que o modelo "não seria capaz de classificar novos pontos de dados". Isso é falso: o KNN com k=4 continua funcionando normalmente. A mudança de k não impede a classificação; apenas altera o número de vizinhos considerados. O modelo sempre será capaz de classificar, desde que haja dados de treinamento e uma métrica de distância definida.
Alternativa B — ✅ Correta ⟵ GABARITO
Esta é a alternativa correta. Com k=4 (número par), em um problema de classificação binária, é possível que a votação entre os 4 vizinhos resulte em empate (2 a 2). Nesses casos, o algoritmo precisa de um critério de desempate para decidir a classe final. Portanto, a afirmação de que "poderia resultar em empates mais frequentes, levando a previsões que dependam mais do critério de desempate do algoritmo" está correta.
Alternativa C — ❌ Incorreta
Afirma que o modelo "consideraria todos os pontos de treinamento para qualquer nova previsão". Isso só seria verdade se k fosse igual ao número total de pontos no conjunto de treinamento. Alterar k de 3 para 4 não faz o modelo considerar todos os pontos; ele continua considerando apenas os 4 vizinhos mais próximos. Além disso, a afirmação de que isso levaria a "resultados mais precisos" é uma generalização incorreta: um k muito grande pode suavizar demais a fronteira de decisão e reduzir a precisão.
Alternativa D — ❌ Incorreta
Afirma que o modelo "poderia fornecer previsões mais sensíveis a mudanças pequenas no dado, com menos probabilidade de empate". Há dois erros aqui. Primeiro, aumentar k de 3 para 4 torna o modelo menos sensível a mudanças pequenas, pois a decisão passa a depender de mais vizinhos, suavizando o efeito de cada ponto individual. Segundo, a probabilidade de empate aumenta com k par, não diminui. Com k=3 (ímpar), empates são impossíveis em problemas binários; com k=4 (par), eles se tornam possíveis.
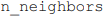 define o número de vizinhos que o classificador KNN irá considerar para realizar a previsão.
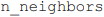 fosse alterado de 3 para 4, o modelo