Questão de Banco de Dados — Banco de Dados Relacionais — CESPE / CEBRASPE 2024
Banco de Dados›Banco de Dados Relacionais
Código
ce191749
Banca
CESPE / CEBRASPE
Órgão
INPI
Ano
2024
Nível
Superior
ALUNOS(ID,Nome,Endereço,Cidade,UF)
DISCIPLINA(Cod_disciplina, Nome_diciplina,
Carga_horaria)
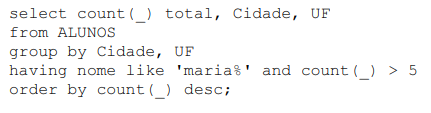
Considerando que as tabelas precedentes façam parte de um banco de dados relacional, julgue o item subsequente.O comando a seguir está sintaticamente correto em PostgreSql.
CCerto
EErrado
Revelar gabarito e comentário▾
GabaritoE — Errado
Comentário gerado por IA. É um apoio ao estudo, ancorado em fontes, mas pode conter imprecisões — confira sempre na fonte oficial (lei, súmula, edital e gabarito da banca). Encontrou um erro? Use “Reportar”.
PostgreSQL: sintaxe do comando SELECT
Gabarito: Errado. O comando apresentado está sintaticamente incorreto em PostgreSQL porque utiliza count(_) — um underscore isolado como argumento da função de agregação —, o que não é uma sintaxe válida; o correto seria count(*) para contar todas as linhas ou count(coluna) para contar valores não nulos de uma coluna específica. Além disso, a cláusula HAVING referencia a coluna nome, que não está incluída na cláusula GROUP BY, violando a regra do SQL que exige que colunas não agregadas no HAVING estejam no GROUP BY.
O comando SELECT é a instrução fundamental de consulta em SQL, usada para recuperar dados de uma ou mais tabelas de um banco de dados relacional. Sua estrutura básica é composta por cláusulas que definem quais colunas serão retornadas (SELECT), de quais tabelas (FROM), como os dados serão filtrados (WHERE), agrupados (GROUP BY), filtrados após o agrupamento (HAVING) e ordenados (ORDER BY). Cada cláusula tem uma função específica e deve seguir regras sintáticas e semânticas para que a consulta seja válida.
A função COUNT é uma função de agregação que conta o número de linhas ou valores não nulos em um conjunto de dados. Em PostgreSQL, a forma mais comum é COUNT(*), que conta todas as linhas do grupo, incluindo aquelas com valores nulos. Também é possível usar COUNT(expressão), que conta apenas as linhas onde a expressão não é nula. A sintaxe count(_) não é reconhecida pelo PostgreSQL, pois _ não é um identificador válido de coluna ou expressão nesse contexto — é um erro de sintaxe.
A cláusula HAVING é usada para filtrar grupos após a aplicação do GROUP BY, permitindo condições sobre funções de agregação ou colunas agrupadas. No comando em questão, a condição nome like 'maria%' referencia a coluna nome, que não está presente na cláusula GROUP BY (que agrupa por Cidade e UF). Isso viola a regra do SQL que determina que, em uma consulta com GROUP BY, qualquer coluna referenciada no HAVING deve ser uma coluna agrupada ou estar dentro de uma função de agregação. Portanto, mesmo que a sintaxe do count(_) fosse corrigida, a consulta ainda seria inválida por essa razão.
Na prática, para que a consulta fosse correta, ela deveria ser reescrita, por exemplo, como:
select count(*) total, Cidade, UF
from ALUNOS
group by Cidade, UF
having count(*) > 5
order by count(*) desc;
Nessa versão, a condição do HAVING usa apenas a função de agregação count(*), que é permitida, e a coluna nome não é referenciada indevidamente. A pegadinha da banca está em apresentar um comando que parece plausível, mas contém dois erros: o uso de count(_) e a referência a uma coluna não agrupada no HAVING. O candidato que conhece a sintaxe correta do PostgreSQL identifica esses problemas e marca o item como errado.
NÃO CAIA NESSA!
A banca explora dois erros sutis: o uso de count(_) em vez de count(*) e a referência à coluna nome no HAVING sem que ela esteja no GROUP BY. O candidato desatento pode achar que o comando está correto, mas ambos os pontos tornam a consulta inválida em PostgreSQL.
1count(_) inválido
2Correto: count(*) ou count(coluna)
3HAVING com coluna não agrupada
4Exigência: coluna no GROUP BY
LEVEL · soulevel.com.br
Alternativa E — ❌ Errado ⟵ GABARITO
O comando está incorreto por dois motivos principais. Primeiro, count(_) não é uma sintaxe válida em PostgreSQL; a forma correta é count(*) ou count(coluna). Segundo, a cláusula HAVING referencia a coluna nome, que não está incluída no GROUP BY (que agrupa por Cidade e UF), violando a regra de que colunas não agregadas no HAVING devem estar no GROUP BY. Esses erros tornam o comando sintaticamente incorreto, confirmando o gabarito.