Questão de Programação — Linguagens de programação — CESPE / CEBRASPE 2025
Programação›Linguagens de programação
Código
ce198709
Banca
CESPE / CEBRASPE
Órgão
EMBRAPA
Ano
2025
Nível
Superior
Cargo
Analista - Área: Gestão da Informação - Subárea: Avaliação de Impactos
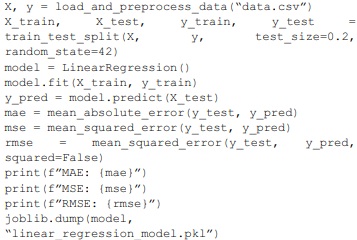
A partir do código precedente, considerando que todas as bibliotecas, dados e módulos necessários para a execução sem qualquer tipo de erro ou incompletude já tenham sido importados e configurados previamente, julgue o item a seguir.Essencialmente, y_pred contém as previsões do modelo sobre os valores correspondentes de saída que o modelo estima com base nas características fornecidas em X_test.
CCerto
EErrado
Revelar gabarito e comentário▾
GabaritoC — Certo
Comentário gerado por IA. É um apoio ao estudo, ancorado em fontes, mas pode conter imprecisões — confira sempre na fonte oficial (lei, súmula, edital e gabarito da banca). Encontrou um erro? Use “Reportar”.
Regressão Linear em Python: previsões com X_test
Gabarito: C (CERTO). A variável y_pred armazena exatamente o que o enunciado afirma: as previsões do modelo de regressão linear para os valores de saída, calculadas a partir das características contidas em X_test. Isso é confirmado pela linha y_pred = model.predict(X_test), que aplica o modelo treinado ao conjunto de teste.
O código apresentado implementa um pipeline clássico de aprendizado de máquina supervisionado. Primeiro, os dados são carregados e pré-processados. Em seguida, o conjunto é dividido em treino e teste com train_test_split, usando 20% dos dados para teste. O modelo LinearRegression() é então treinado com model.fit(x_train, y_train), ou seja, ele aprende a relação entre as características (x_train) e os valores de saída (y_train).
A etapa crucial é a previsão: model.predict(X_test). O método predict recebe como argumento as características do conjunto de teste e retorna um array com os valores estimados pelo modelo para cada uma dessas amostras. Esse array é atribuído a y_pred. Portanto, y_pred contém as previsões do modelo para os dados de X_test, exatamente como descrito no enunciado.
As métricas calculadas em seguida (mae, mse, rmse) servem para avaliar a qualidade dessas previsões, comparando y_pred com os valores reais y_test. O joblib.dump salva o modelo treinado em um arquivo para uso futuro. Todo o fluxo é padrão e a afirmação do item é uma descrição precisa do que o código faz.
A distinção importante aqui é entre o conjunto de treino e o de teste. O modelo é treinado com x_train e y_train, mas as previsões são feitas sobre X_test, que o modelo nunca viu durante o treinamento. É essa separação que permite avaliar se o modelo generaliza bem para dados novos. O enunciado captura corretamente esse papel de y_pred.
A pegadinha que a banca poderia explorar seria inverter os conjuntos, afirmando que y_pred contém previsões sobre x_train ou que o modelo foi treinado com X_test. Mas o enunciado está correto ao afirmar que as previsões são sobre X_test. Portanto, o item está CERTO.
1Carregar e pré-processar dados
2Dividir em treino e teste
3Treinar modelo (fit)
4Prever com X_test (predict)
5Avaliar com métricas
LEVEL · soulevel.com.br
Item — ✅ CERTO ⟵ GABARITO
A afirmação descreve com precisão o que a linha y_pred = model.predict(X_test) faz. O método predict do modelo treinado recebe as características de entrada (X_test) e retorna as saídas estimadas (y_pred). Não há erro conceitual ou técnico na afirmação.