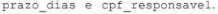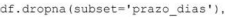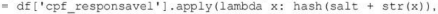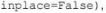Questão de Noções de Informática — Software — FCC 2026
Noções de Informática›Software
Código
fc076410
Banca
FCC
Órgão
CPU-PE
Ano
2026
Nível
Superior
Cargo
Gestor Governamental - Especialidade: Planejamento, Orçamento e Gestão
Uma equipe de planejamento da SEPLAG está preparando um conjunto de dados para análise em Python, usando Pandas. O DataFrame contém informações sobre projetos estratégicos, incluindo colunas como Durante a análise exploratória, foram identificados valores ausentes em duplicatas em e valores extremos em Além disso, os dados serão compartilhados com parceiros externos. Em condições ideais, uma prática que se adequaa este cenário é

Acriar os gráficos finais primeiro e realizar a análise exploratória em seguida, pois isso evita alterações nos dados que possam comprometer a visualização.
Bremover valores ausentes em usando o que garante que todos os registros com dados incompletos sejam eliminados.
Caplicar um tipo de anonimização na coluna com o que converte os CPFs em identificadores não reversíveis e menos suscetiveis à reidentificação.
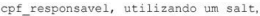

Dpromover a detecção de outliers em usando pois esses valores indicam desvios estatísticos significativos em relação à média ou à massa total dos dados.

Eremover duplicatas em , usando o comando que verifica a coluna e remove todos os registros duplicados diretamente sobre o Dataframe .

Revelar gabarito e comentário▾
GabaritoC — aplicar um tipo de anonimização na coluna [imagem] com [imagem][imagem] o que converte os CPFs em identificadores não reversíveis e menos suscetiveis à reidentificação.
Comentário gerado por IA. É um apoio ao estudo, ancorado em fontes, mas pode conter imprecisões — confira sempre na fonte oficial (lei, súmula, edital e gabarito da banca). Encontrou um erro? Use “Reportar”.
Anonimização de dados em Python com Pandas
Gabarito: letra C. A anonimização é uma técnica fundamental de proteção de dados, especialmente quando informações sensíveis, como o CPF, precisam ser compartilhadas com terceiros. Ao aplicar um processo de hash ou criptografia irreversível, garante-se que os dados originais não possam ser facilmente recuperados, mitigando riscos de reidentificação e cumprindo boas práticas de privacidade.
Alternativa A — ❌ Incorreta
A análise exploratória de dados (EDA) deve preceder a criação de gráficos. Realizar a visualização antes de tratar os dados pode levar a conclusões errôneas, pois valores ausentes ou extremos não tratados distorcem as métricas e os padrões visuais.
Alternativa B — ❌ Incorreta
Remover indiscriminadamente valores ausentes pode reduzir drasticamente o tamanho da amostra e introduzir viés, especialmente se os dados não estiverem ausentes de forma aleatória. O tratamento ideal envolve técnicas como imputação (preenchimento com média, mediana ou moda) ou análise do impacto da remoção antes de executá-la.
Alternativa C — ✅ Correta ⟵ GABARITO
Esta é a prática correta para o cenário de compartilhamento externo. A anonimização transforma identificadores diretos (como o CPF) em identificadores únicos, porém não reversíveis, preservando a utilidade dos dados para análise sem expor a identidade dos indivíduos.
Alternativa D — ❌ Incorreta
A detecção de outliers é uma etapa da análise, mas a alternativa falha ao sugerir que a simples detecção é a prática ideal. Outliers não devem ser automaticamente removidos ou tratados apenas porque indicam desvios; é necessário investigar se são erros de medição ou variações legítimas e significativas do fenômeno estudado.
Alternativa E — ❌ Incorreta
A remoção de duplicatas deve ser feita com cautela. O comando para remover duplicatas no Pandas é drop_duplicates(), mas a alternativa sugere uma verificação genérica que pode apagar registros legítimos se não houver uma análise prévia sobre quais colunas definem a unicidade de um registro no contexto do projeto.
PEGA ESSA DICA!
Ao trabalhar com dados sensíveis, priorize sempre a anonimização ou pseudonimização antes de qualquer compartilhamento externo. No Pandas, técnicas de hash (como o uso da biblioteca hashlib) são comumente aplicadas para transformar colunas de identificação em strings alfanuméricas seguras.