Questão de Banco de Dados — Consultas e Comandos em SQL — FCC 2025
Banco de Dados›Consultas e Comandos em SQL
Código
fc150368
Banca
FCC
Órgão
TRT 2
Ano
2025
Cargo
AJ TRT2
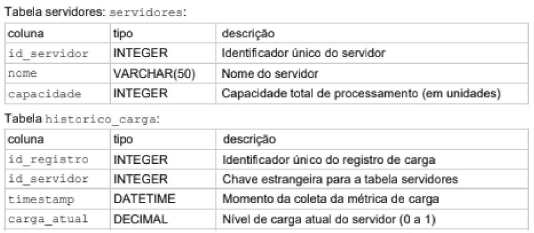
Um Analista Judiciário de um Tribunal do Trabalho está investigando o desempenho de diferentes servidores que hospedam os sistemas processuais eletrônicos. Ele possui as seguintes tabelas em um banco de dados SQL no padrão ANSI: O Analista precisa identificar o nome dos servidores que, em algum momento, registraram uma carga superior a 80% (0.8) de sua capacidade total e utiliza, corretamente, a consulta SQL padrão ANSI
ASELECT s.nome FROM servidores s, historico_carga h WHERE s.id_servidor = h.id_servidor AND h.carga_atual / s.capacidade > 0.8;
BSELECT DISTINCT nome FROM servidores WHERE id_servidor = ANY (SELECT id_servidor FROM historico_carga WHERE carga_atual > 0.8);
CSELECT s.nome FROM servidores s WHERE EXISTS (SELECT 1 FROM historico_carga h WHERE h.id_servidor = s.id_servidor AND h.carga_atual > 0.8);
DSELECT DISTINCT s.nome FROM servidores s JOIN historico_carga h ON s.id_servidor = h.id_servidor WHERE h.carga_atual > 0.8 * s.capacidade;
ESELECT s.nome FROM servidores s WHERE s.id_servidor IN (SELECT id_servidor FROM historico_carga WHERE carga_atual > 0.8);
Revelar gabarito e comentário▾
GabaritoD — SELECT DISTINCT s.nome FROM servidores s
JOIN historico_carga h ON s.id_servidor = h.id_servidor
WHERE h.carga_atual > 0.8 * s.capacidade;
Comentário gerado por IA. É um apoio ao estudo, ancorado em fontes, mas pode conter imprecisões — confira sempre na fonte oficial (lei, súmula, edital e gabarito da banca). Encontrou um erro? Use “Reportar”.
Consultas SQL: junção, subconsulta e filtro por proporção
Gabarito: letra D. A consulta correta precisa comparar a carga registrada com a capacidade total do servidor — ou seja, filtrar h.carga_atual > 0.8 * s.capacidade — e, como um mesmo servidor pode ter vários registros no histórico, deve usar DISTINCT para não repetir nomes. A alternativa D faz exatamente isso com um JOIN explícito entre as tabelas, atendendo ao padrão ANSI.
O problema pede para identificar servidores que, em algum momento, tiveram carga superior a 80% da capacidade. Isso significa que a consulta deve cruzar as duas tabelas (servidores e historico_carga) pela chave id_servidor e aplicar um filtro que relacione a carga atual com a capacidade total. A condição correta é h.carga_atual > 0.8 * s.capacidade, pois compara o valor registrado com o limite calculado. Como o histórico pode ter várias linhas para o mesmo servidor, o SELECT DISTINCT garante que cada nome apareça apenas uma vez no resultado.
Vamos analisar cada alternativa para entender por que apenas a D está correta. A alternativa A usa uma junção implícita (vírgula no FROM) e a condição correta, mas não usa DISTINCT — se um servidor tiver mais de um registro acima do limite, seu nome aparecerá repetido. A alternativa B usa ANY com uma subconsulta, mas a subconsulta compara carga_atual > 0.8sem considerar a capacidade do servidor — ela filtra apenas cargas absolutas acima de 0.8, o que não atende ao enunciado. A alternativa C usa EXISTS com uma subconsulta correlacionada, mas também não considera a capacidade — filtra apenas cargas absolutas acima de 0.8. A alternativa E usa IN com uma subconsulta, mas sem considerar a capacidade e sem DISTINCT — além de não atender ao critério, pode repetir nomes. A alternativa D é a única que combina JOIN, DISTINCT e a condição correta.
NÃO CAIA NESSA!
A banca adora trocar a condição de proporção por uma comparação absoluta. Aqui, as alternativas B, C e E filtram carga_atual > 0.8 sem relacionar com a capacidade — o que não atende ao enunciado. A alternativa A usa a condição correta, mas esquece o DISTINCT, repetindo nomes. Fique atento: a condição deve ser h.carga_atual > 0.8 * s.capacidade e o DISTINCT é essencial para evitar duplicatas.
1JOIN servidores × historico
2Filtro: carga > 0.8 × capacidade
3DISTINCT para evitar duplicatas
LEVEL · soulevel.com.br
Alternativa A — ❌ Incorreta
A consulta usa uma junção implícita (vírgula no FROM) e a condição correta h.carga_atual / s.capacidade > 0.8, mas não usa DISTINCT. Se um servidor tiver mais de um registro no histórico com carga acima do limite, seu nome aparecerá repetido no resultado. O enunciado pede o nome dos servidores — sem repetição —, então a falta de DISTINCT torna a consulta incorreta.
Alternativa B — ❌ Incorreta
A subconsulta filtra carga_atual > 0.8sem considerar a capacidade do servidor. Isso significa que ela retorna servidores cuja carga absoluta é maior que 0.8, mas não necessariamente maior que 80% da capacidade. Por exemplo, um servidor com capacidade 100 e carga 0.9 não seria retornado, pois 0.9 < 80. A condição correta deve ser carga_atual > 0.8 * capacidade.
Alternativa C — ❌ Incorreta
A subconsulta correlacionada com EXISTS verifica se existe algum registro no histórico com carga_atual > 0.8, mas sem considerar a capacidade. Assim como na alternativa B, ela não atende ao critério de proporção. Além disso, a subconsulta não referencia a capacidade do servidor, então o filtro é incorreto.
Alternativa D — ✅ Correta ⟵ GABARITO
A consulta usa JOIN explícito entre servidores e historico_carga pela chave id_servidor, aplica a condição correta h.carga_atual > 0.8 * s.capacidade e usa DISTINCT para evitar nomes repetidos. Isso atende exatamente ao enunciado: identificar os nomes dos servidores que, em algum momento, registraram carga superior a 80% da capacidade.
Alternativa E — ❌ Incorreta
A subconsulta com IN filtra carga_atual > 0.8sem considerar a capacidade e sem DISTINCT. Além de não atender ao critério de proporção, se um servidor tiver vários registros acima do limite, seu nome aparecerá repetido no resultado. A condição correta deve ser carga_atual > 0.8 * capacidade e o DISTINCT é necessário.