Analista Legislativo - Informática Legislativa - Tarde
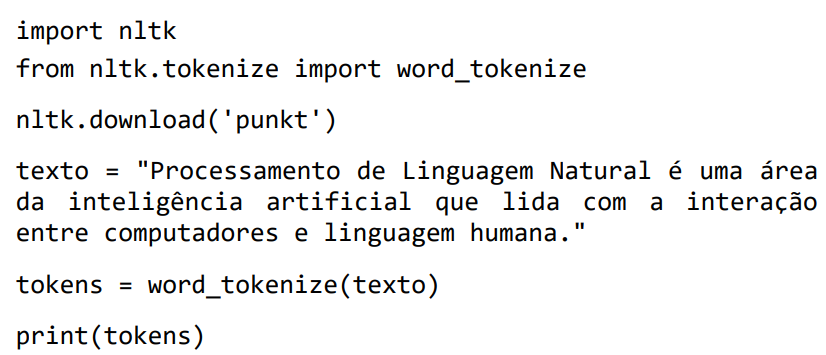
Considere o código em Python que utiliza a biblioteca NLTK (Natural Language Toolkit) a seguir.Assinale a opção que corresponde ao propósito do código apresentado.
ARealizar a tradução automática de um texto de um idioma para outro.
BAnalisar a estrutura gramatical de um texto.
CExtrair informações relevantes de um texto, como entidades nomeadas.
DSintetizar um texto a partir de um conjunto de palavras-chave.
ERealizar a tokenização do texto, ou seja, dividir o texto em palavras ou unidades significativas.
Revelar gabarito e comentário▾
GabaritoE — Realizar a tokenização do texto, ou seja, dividir o texto em palavras ou unidades significativas.
Comentário gerado por IA. É um apoio ao estudo, ancorado em fontes, mas pode conter imprecisões — confira sempre na fonte oficial (lei, súmula, edital e gabarito da banca). Encontrou um erro? Use “Reportar”.
Tokenização com NLTK em Python
Gabarito: letra E. O código apresentado utiliza a biblioteca NLTK para realizar a tokenização do texto, ou seja, dividir o texto em palavras ou unidades significativas, conforme descrito na alternativa E. A função word_tokenize() é a principal responsável por essa tarefa, separando o texto em tokens (palavras).
A tokenização é uma etapa fundamental no processamento de linguagem natural (PLN), que consiste em quebrar um texto em unidades menores, chamadas de tokens. Esses tokens podem ser palavras, pontuações ou outros elementos significativos. No NLTK, a função word_tokenize() é usada para dividir um texto em palavras, enquanto sent_tokenize() divide em sentenças. O código provavelmente importa o NLTK, define um texto e aplica word_tokenize() para obter a lista de palavras.
A biblioteca NLTK (Natural Language Toolkit) é uma plataforma Python para processamento de linguagem natural, fornecendo bibliotecas para classificação, tokenização, lematização, marcação, análise e raciocínio semântico. As principais funções de tokenização são:
sent_tokenize(texto): separa o texto em sentenças.
word_tokenize(texto): separa o texto em palavras.
Essas funções são essenciais para preparar o texto para análises posteriores, como análise gramatical, extração de entidades nomeadas ou tradução automática. A tokenização é o primeiro passo em muitos pipelines de PLN.
A pegadinha desta questão está em confundir tokenização com outras tarefas de PLN, como análise gramatical, extração de informações ou tradução. A banca explora o fato de que o candidato pode não conhecer as funções específicas do NLTK e acabar escolhendo uma alternativa mais genérica. No entanto, a alternativa E descreve exatamente o que a função word_tokenize() faz.
Guarde a distinção entre as principais funções do NLTK: word_tokenize() divide em palavras, sent_tokenize() divide em sentenças, pos_tag() faz a marcação gramatical, ne_chunk() extrai entidades nomeadas. É exatamente essa fronteira que separa as alternativas.
A tradução automática é uma tarefa complexa que envolve modelos de linguagem e não é realizada apenas com tokenização. O NLTK não possui uma função direta de tradução automática; isso seria feito com bibliotecas como googletrans ou modelos de aprendizado de máquina. O código apresentado não contém chamadas para tradução.
Alternativa B — ❌ Incorreta
A análise da estrutura gramatical de um texto é feita com funções como pos_tag() (marcação de classes gramaticais) ou nltk.parse (análise sintática). A tokenização apenas divide o texto em palavras, sem analisar a estrutura gramatical. O código não utiliza essas funções.
Alternativa C — ❌ Incorreta
A extração de entidades nomeadas é feita com ne_chunk() ou bibliotecas como spaCy. A tokenização não extrai informações relevantes, apenas divide o texto. O código não contém chamadas para extração de entidades.
Alternativa D — ❌ Incorreta
A síntese de texto a partir de palavras-chave é uma tarefa de geração de texto, que não é realizada por tokenização. O NLTK não possui uma função direta para isso. O código não gera texto novo.
Alternativa E — ✅ Correta ⟵ GABARITO
A tokenização é exatamente o propósito do código. A função word_tokenize() divide o texto em palavras, que são as unidades significativas. O NLTK fornece essa função especificamente para essa tarefa, e o código provavelmente a utiliza para processar o texto.
PEGA ESSA DICA!
Para identificar a função correta em questões de NLTK, lembre-se: word_tokenize() divide em palavras, sent_tokenize() divide em sentenças, pos_tag() marca classes gramaticais, ne_chunk() extrai entidades nomeadas. Associe cada função à sua tarefa específica.
 Assinale a opção que corresponde ao propósito do código apresentado.