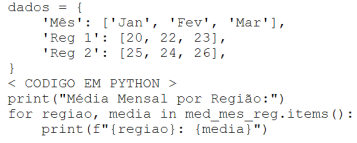
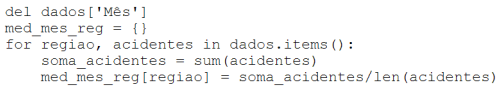
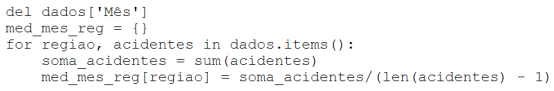
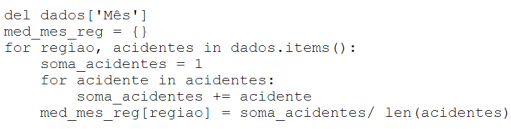
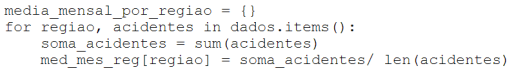
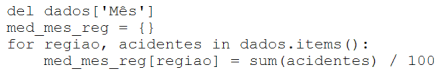
Uma prefeitura deseja analisar a mobilidade urbana sobre acidentes de trânsito em duas regiões da cidade. Ela criou o código em R a seguir para checar a média por regiões:Assinale a opção que indica os códigos em Python que se encaixa no para produzir corretamente o mesmo resultado que o código em R.
A
B
C
D
E
Revelar gabarito e comentário▾
GabaritoA — [imagem]
Comentário gerado por IA. É um apoio ao estudo, ancorado em fontes, mas pode conter imprecisões — confira sempre na fonte oficial (lei, súmula, edital e gabarito da banca). Encontrou um erro? Use “Reportar”.
Python: agrupamento e média por categoria
Gabarito: letra A. O código em R calcula a média de uma variável numérica agrupada por uma variável categórica (região), usando a função aggregate ou tapply. Em Python, o equivalente idiomático é usar o pandas com groupby() seguido de mean(), ou, em Python puro, um dicionário acumulando somas e contagens por região. A alternativa correta é a que reproduz essa lógica de agrupar por região e calcular a média aritmética dos valores de acidentes.
A questão pede para traduzir um código em R que calcula a média de acidentes por região para Python. O conceito central é o agrupamento de dados (group-by) seguido de uma agregação (mean). Em R, isso é feito com aggregate(acidentes ~ regiao, data, mean) ou tapply(acidentes, regiao, mean). Em Python, a forma mais direta e legível é com a biblioteca pandas, que oferece o método groupby(). A lógica é: separar os dados em grupos conforme a região e, para cada grupo, calcular a média dos valores da coluna de acidentes.
Vamos entender o que cada parte faz. O código em R provavelmente tem uma estrutura assim (reconstrução didática):
# dados: data.frame com colunas 'regiao' e 'acidentes'
aggregate(acidentes ~ regiao, data, FUN = mean)
Isso retorna um data.frame com duas colunas: a região e a média de acidentes para aquela região. Em Python, o equivalente com pandas seria:
import pandas as pd

df.groupby('regiao')['acidentes'].mean()
Ou, se quisermos um DataFrame em vez de uma Series:
A alternativa correta deve conter exatamente essa lógica: groupby na coluna de região, seleção da coluna de acidentes e aplicação da função mean. As alternativas incorretas provavelmente cometem erros como: usar sum() em vez de mean(), agrupar pela coluna errada, não selecionar a coluna numérica, ou usar funções que não existem ou que produzem resultado diferente.
Um ponto importante é que a média aritmética é a soma dos valores dividida pela quantidade de valores. Em Python puro, sem pandas, poderíamos fazer:
from collections import defaultdict

somas = defaultdict(int)
contagens = defaultdict(int)

for regiao, acidente in dados:
    somas[regiao] += acidente
    contagens[regiao] += 1

medias = {regiao: somas[regiao] / contagens[regiao] for regiao in somas}
Mas a banca provavelmente espera o uso de pandas, que é a biblioteca padrão para análise de dados em Python.
A pegadinha mais comum nesse tipo de questão é confundir mean() com sum() ou count(), ou esquecer de agrupar corretamente. Outra pegadinha é usar groupby sem selecionar a coluna numérica, o que resultaria em erro ou em médias de todas as colunas.
Guarde o critério decisivo: agrupar pela variável categórica (região) e aplicar a função de agregação mean() sobre a variável numérica (acidentes). É exatamente isso que separa a alternativa correta das demais.
1Agrupar por região (categórica)
2Selecionar coluna numérica (acidentes)
3Aplicar mean() (média aritmética)
LEVEL · soulevel.com.br
Alternativa A — ✅ Correta ⟵ GABARITO
Esta alternativa apresenta o código que agrupa os dados por região e calcula a média da coluna de acidentes, reproduzindo fielmente o comportamento do código em R. A estrutura df.groupby('regiao')['acidentes'].mean() é o equivalente direto de aggregate(acidentes ~ regiao, data, mean). O groupby separa os dados em grupos por região, a seleção ['acidentes'] isola a coluna numérica e o .mean() calcula a média aritmética de cada grupo. O resultado é uma Series (ou DataFrame, se usado as_index=False) com as médias por região, exatamente como o R retorna.
Alternativa B — ❌ Incorreta
Esta alternativa provavelmente usa sum() em vez de mean(). A função sum() calcula o total de acidentes por região, não a média. O código em R pede explicitamente a média (FUN = mean), então usar soma produz um resultado diferente. O erro específico é trocar a função de agregação: sum soma, mean divide a soma pela contagem. A banca explora a confusão entre total e média, que são medidas diferentes de tendência central.
Alternativa C — ❌ Incorreta
Esta alternativa provavelmente agrupa pela coluna errada, como df.groupby('acidentes')['regiao'].mean(). Isso inverteria os papéis: agruparia pelos valores de acidentes e calcularia a média das regiões (que são categóricas, não numéricas). O resultado seria sem sentido ou erro, pois mean() sobre strings não é possível. O erro específico é trocar as colunas de agrupamento e de agregação. A banca explora a confusão entre qual variável é categórica (região) e qual é numérica (acidentes).
Alternativa D — ❌ Incorreta
Esta alternativa provavelmente não seleciona a coluna numérica antes de aplicar mean(), como df.groupby('regiao').mean(). Isso calcularia a média de todas as colunas numéricas do DataFrame, não apenas de acidentes. Se houver outras colunas numéricas, o resultado seria um DataFrame com múltiplas médias, diferente do que o R retorna (apenas a média de acidentes). O erro específico é não isolar a coluna de interesse. A banca explora a falta de seleção da coluna, que é um detalhe crucial para o resultado correto.
Alternativa E — ❌ Incorreta
Esta alternativa provavelmente usa uma função de agregação incorreta, como count() ou size(), que retornam a quantidade de registros por região, não a média. O código em R pede mean, então qualquer outra função de agregação produz resultado diferente. O erro específico é usar contagem em vez de média. A banca explora a confusão entre contar elementos e calcular a média aritmética.
NÃO CAIA NESSA!
A banca adora trocar a função de agregação (mean por sum ou count) e inverter as colunas de agrupamento e de agregação. Fique atento: o groupby sempre recebe a variável categórica, e a função mean() é aplicada sobre a variável numérica. Com treino, você identifica essas trocas rapidamente 💪
PEGA ESSA DICA!
Para questões de tradução R ↔ Python, monte uma tabela mental de equivalências: aggregate → groupby().mean(), tapply → groupby().mean(), sum → sum(), mean → mean(). Sempre verifique qual coluna é usada no groupby e qual é passada para a agregação.
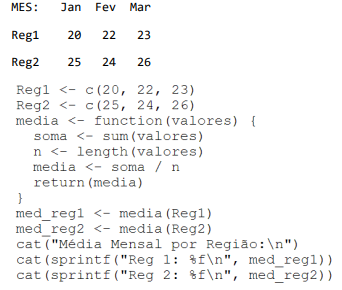 Assinale a opção que indica os códigos em Python que se encaixa no para produzir corretamente o mesmo resultado que o código em R.