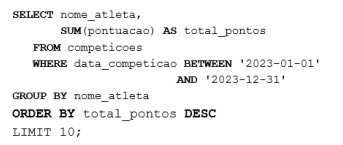
O Comitê Olímpico Brasileiro utiliza um banco de dados em memória para avaliar o desempenho dos atletas em competições ao longo do ano.Considere a seguinte consulta SQL que busca os 10 melhores atletas do Brasil com base em suas pontuações em competições oficiais durante o ano de 2023:A otimização mais eficaz para melhorar o desempenho dessa consulta no banco de dados em memória utilizado pelo Comitê Olímpico seria
Acriar um índice na coluna data_competicao.
Bparticionar a tabela competicoes por ano.
Cmaterializar uma view pré-agregada com as pontuações totais dos atletas por ano.
Dutilizar um banco de dados NoSQL orientado a documentos.
Eaplicar algoritmos de aprendizado de máquina para prever os atletas com as melhores pontuações.
Revelar gabarito e comentário▾
GabaritoC — materializar uma view pré-agregada com as pontuações totais dos atletas por ano.
Comentário gerado por IA. É um apoio ao estudo, ancorado em fontes, mas pode conter imprecisões — confira sempre na fonte oficial (lei, súmula, edital e gabarito da banca). Encontrou um erro? Use “Reportar”.
Otimização de consultas SQL: o papel das views materializadas
Gabarito: letra C. A consulta agrega pontuações por atleta ao longo de um ano e retorna os 10 maiores totais — um padrão analítico que exige varrer todas as competições do ano, somar por atleta e ordenar. A otimização mais eficaz é materializar uma view pré-agregada com as pontuações totais por atleta e ano, pois elimina a varredura e a agregação a cada execução, devolvendo o resultado praticamente pronto. As demais alternativas atacam pontos secundários ou são inadequadas ao cenário.
A consulta descrita é um clássico de agregação pesada: ela precisa percorrer todas as competições de 2023, agrupar por atleta, somar as pontuações e ordenar para extrair o top 10. Em um banco de dados em memória, os dados já estão em RAM, então o gargalo não é I/O de disco — é o custo de CPU de varrer, agregar e ordenar a cada execução. É exatamente esse custo que a view materializada ataca: ela pré-computa o resultado da agregação e o armazena fisicamente, de modo que a consulta final lê apenas as linhas já agregadas (uma por atleta) e ordena — uma operação trivial comparada à varredura original.
Uma view materializada é um objeto do banco que armazena fisicamente o resultado de uma consulta, diferente de uma view comum, que é apenas uma definição reexecutada a cada acesso. O ganho é enorme quando a consulta é frequente e custosa, como é o caso: o Comitê Olímpico provavelmente avalia o desempenho dos atletas repetidamente ao longo do ano. O custo é a manutenção da view — ela precisa ser atualizada (refrescada) quando os dados de origem mudam, seja por refresh completo ou incremental. No contexto de um banco em memória, essa atualização pode ser feita de forma controlada, e o benefício de ter o top 10 instantâneo supera em muito o custo.
Para entender por que as outras opções são inferiores, é preciso distinguir os mecanismos de otimização:
Mecanismo
O que faz
Eficácia neste caso
Índice em data_competicao
Acelera filtros por faixa de data
Baixa — o filtro por ano reduz o volume, mas a agregação e a ordenação continuam pesadas
Particionamento por ano
Divide a tabela em partições físicas
Média — ajuda a podar partições, mas não elimina a agregação
View materializada pré-agregada
Pré-computa a soma por atleta/ano
Alta — elimina a varredura e a agregação na consulta final
Banco NoSQL
Troca o modelo de dados
Inadequada — a consulta é relacional e agregação pesada não é o ponto forte de NoSQL
Aprendizado de máquina
Prevê pontuações futuras
Inadequada — não responde à consulta real, que exige valores exatos
A pegadinha desta questão está em confundir otimização de acesso (índice) com otimização de processamento (agregação pré-computada). O índice em data_competicao é a resposta intuitiva, mas ele apenas acelera a localização das linhas do ano — a soma por atleta e a ordenação continuam sendo feitas a cada execução. A view materializada, por outro lado, elimina o trabalho pesado de uma vez, transformando a consulta em uma leitura simples de um resultado já pronto.
Guarde o critério decisivo: quando a consulta é frequente, custosa e o resultado é uma agregação, a view materializada é a otimização mais eficaz — ela troca o custo de processamento repetido por um custo de armazenamento e manutenção. É esse critério que separa a alternativa correta das demais.
Otimização de consulta SQL
1Gargalo real
Agregação pesada (CPU)
Ordenação do top 10
2View materializada
Pré-agrega por atleta/ano
Consulta final lê resultado pronto
Custo: refresh/manutenção
3Alternativas insuficientes
Índice em data_competicao
Acelera filtro, não a agregação
Particionamento por ano
Poda partição, não a agregação
NoSQL
Modelo inadequado a GROUP BY
Aprendizado de máquina
Prevê, não responde à consulta
LEVEL · soulevel.com.br
Alternativa A — ❌ Incorreta
Criar um índice na coluna data_competicao acelera o filtro WHERE data_competicao BETWEEN '2023-01-01' AND '2023-12-31', reduzindo o número de linhas varridas. Porém, a consulta ainda precisa agregar as pontuações por atleta e ordenar os totais — operações que o índice não elimina. Em um banco em memória, onde o I/O não é o gargalo, o ganho do índice é marginal; o custo dominante é a agregação, que permanece intacta.
Alternativa B — ❌ Incorreta
Particionar a tabela competicoes por ano permite a poda de partições — o banco lê apenas a partição de 2023, ignorando as demais. Isso reduz o volume de dados varridos, mas, assim como o índice, não elimina a agregação por atleta nem a ordenação. O particionamento é uma boa prática para tabelas grandes, mas não é a otimização mais eficaz para uma consulta que agrega e ordena.
Alternativa C — ✅ Correta ⟵ GABARITO
Materializar uma view pré-agregada com as pontuações totais dos atletas por ano é a otimização mais eficaz. A view armazena fisicamente o resultado da agregação (SELECT atleta, SUM(pontuacao) FROM competicoes WHERE ano = 2023 GROUP BY atleta), de modo que a consulta final apenas lê essa view e ordena os totais para extrair o top 10. O custo pesado de varrer e agregar é pago uma vez (na criação/refresh da view), e não a cada execução. Em um banco em memória, onde a consulta é frequente, esse é o ganho mais significativo.
Alternativa D — ❌ Incorreta
Trocar o banco relacional por um NoSQL orientado a documentos é uma mudança de arquitetura drástica e inadequada ao problema. A consulta exige agregação e ordenação sobre dados estruturados e relacionais — exatamente o ponto forte dos bancos SQL. Bancos NoSQL são mais adequados para escalabilidade horizontal e dados sem esquema rígido, não para consultas analíticas com GROUP BY e ORDER BY pesados. Além disso, a migração não resolve o gargalo de agregação; apenas o transfere para um modelo menos adequado.
Alternativa E — ❌ Incorreta
Aplicar aprendizado de máquina para prever os atletas com melhores pontuações é conceitualmente errado: a consulta pede os 10 melhores com base em pontuações reais de 2023, não previsões. Um modelo preditivo não responde à consulta — ele estima valores futuros, que podem divergir dos reais. Além disso, introduzir ML para uma consulta SQL simples é um exagero desproporcional e não otimiza o desempenho da consulta em si.
NÃO CAIA NESSA!
A banca explora a confusão entre otimização de acesso (índice) e otimização de processamento (agregação pré-computada). O candidato que pensa "a consulta filtra por ano, então índice em data ajuda" cai na alternativa A. Mas o filtro por ano é apenas o primeiro passo; o custo dominante é somar as pontuações de todos os atletas e ordenar. A view materializada elimina exatamente esse custo, tornando a consulta final trivial. Com treino, você aprende a identificar quando o gargalo é a agregação e a escolher a otimização certa 💪.
PEGA ESSA DICA!
Na prova, ao ver uma consulta com GROUP BY + ORDER BY + LIMIT sobre uma tabela grande, pergunte-se: "essa consulta roda com frequência?" Se sim, a resposta quase sempre é view materializada. Índice e particionamento ajudam a filtrar, mas não eliminam a agregação. Guarde a regra: agregação pesada e frequente → materialize a view.
 A otimização mais eficaz para melhorar o desempenho dessa consulta no banco de dados em memória utilizado pelo Comitê Olímpico seria