Auditor Federal de Finanças e Controle - Área de Tecnologia da Informação (Transformação Digital) - manhã
No contexto da tabela IPCA apresentada, o comando SQL a seguir produz o índice acumulado a cada ano, que é obtido pela multiplicação acumulativa de um conjunto de termos da forma (1 + i/100), onde i é o valor do índice em cada um dos doze meses de cada ano.Assinale o trecho que deve substituir o trecho pontilhado do comando acima, de modo que o cálculo e a apresentação sejam produzidos corretamente.
A(select ano - 2021 as ano from IPCA)
B(select ano from IPCA)
C(select distinct ano from IPCA)
D(select distinct ano, mes from IPCA)
Eselect distinct ano from IPCA
Revelar gabarito e comentário▾
GabaritoC — (select distinct ano from IPCA)
Comentário gerado por IA. É um apoio ao estudo, ancorado em fontes, mas pode conter imprecisões — confira sempre na fonte oficial (lei, súmula, edital e gabarito da banca). Encontrou um erro? Use “Reportar”.
SQL: Agrupamento e DISTINCT
SE LIGUE NESSA!
Esta questão depende de um texto-base (a tabela IPCA e o comando SQL completo) que não está disponível aqui. O raciocínio abaixo explica o método para resolver — confira os detalhes no enunciado original.
Gabarito: letra C. O trecho (select distinct ano from IPCA) é o que produz a lista de anos distintos, necessária para que o comando externo calcule o índice acumulado por ano. As demais alternativas ou repetem linhas (A e B), ou incluem o mês na seleção (D), ou estão fora da subconsulta (E).
O comando SQL descrito no enunciado calcula, para cada ano, o produto acumulado dos fatores dos doze meses. Para isso, a consulta externa precisa agrupar os resultados por ano, e a subconsulta deve fornecer exatamente os valores distintos de ano presentes na tabela IPCA. A cláusula DISTINCT é essencial: sem ela, a subconsulta retornaria uma linha para cada registro da tabela (ou seja, uma linha por mês), e o agrupamento externo produziria um resultado por mês, não por ano.
A função de agregação usada para o produto acumulado — tipicamente EXP(SUM(LN(1 + i/100))) ou uma função específica do SGBD — opera sobre o conjunto de linhas de cada grupo. Se a subconsulta não eliminar as duplicatas de ano, cada ano aparecerá doze vezes (uma por mês), e o produto será calculado sobre 144 fatores em vez de 12, gerando um resultado incorreto. O DISTINCT garante que cada ano apareça uma única vez, permitindo que o agrupamento externo funcione corretamente.
Na prática, a estrutura do comando seria algo como:
SELECT ano, EXP(SUM(LN(1 + i/100))) AS acumulado
FROM IPCA
WHERE ano IN (SELECT DISTINCT ano FROM IPCA)
GROUP BY ano;
A subconsulta (SELECT DISTINCT ano FROM IPCA) retorna a lista de anos únicos, e a consulta externa agrupa por esses anos, calculando o produto dos fatores de cada mês. Sem o DISTINCT, a subconsulta retornaria todos os registros (incluindo duplicatas de ano), e o GROUP BY externo ainda agruparia corretamente, mas a subconsulta seria redundante e potencialmente problemática se usada em uma condição IN ou JOIN.
A pegadinha da questão está em distinguir quando usar DISTINCT e quando não usar. A alternativa B (select ano from IPCA) parece correta à primeira vista, mas retorna uma linha por mês, não por ano. A alternativa A (select ano - 2021 as ano from IPCA) adiciona um deslocamento desnecessário. A alternativa D (select distinct ano, mes from IPCA) inclui o mês, o que quebraria o agrupamento por ano. A alternativa E (select distinct ano from IPCA) está correta no conteúdo, mas está fora da subconsulta, o que a torna inválida sintaticamente no contexto do comando.
Alternativa A — ❌ Incorreta
O trecho (select ano - 2021 as ano from IPCA) subtrai 2021 do valor de ano, alterando os dados originais. Isso produziria anos deslocados (ex.: 2021 vira 0, 2022 vira 1), o que não corresponde ao cálculo do índice acumulado. Além disso, não usa DISTINCT, então retornaria uma linha por mês, não por ano.
Alternativa B — ❌ Incorreta
O trecho (select ano from IPCA) retorna uma linha para cada registro da tabela, ou seja, uma linha por mês (12 linhas por ano). Sem DISTINCT, a subconsulta não fornece a lista de anos únicos, e o agrupamento externo não funcionaria como esperado.
Alternativa C — ✅ Correta ⟵ GABARITO
O trecho (select distinct ano from IPCA) retorna exatamente os anos distintos presentes na tabela, sem repetições. Isso permite que a consulta externa agrupe e calcule o índice acumulado por ano corretamente.
Alternativa D — ❌ Incorreta
O trecho (select distinct ano, mes from IPCA) inclui a coluna mes na seleção. Isso faz com que a subconsulta retorne combinações únicas de (ano, mes), ou seja, uma linha por mês de cada ano — o que não resolve o problema de agrupar por ano.
Alternativa E — ❌ Incorreta
O trecho select distinct ano from IPCA está correto no conteúdo, mas está fora da subconsulta (não está entre parênteses). No contexto do comando, o trecho pontilhado deve ser uma subconsulta, e a ausência dos parênteses torna a sintaxe inválida.
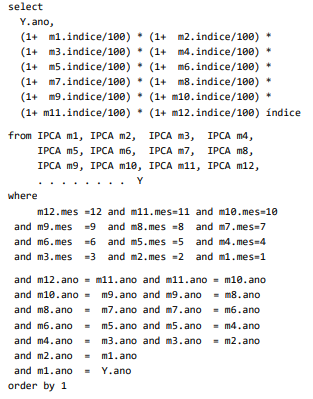 Assinale o trecho que deve substituir o trecho pontilhado do comando acima, de modo que o cálculo e a apresentação sejam produzidos corretamente.