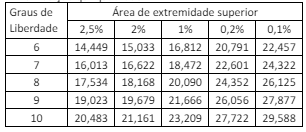
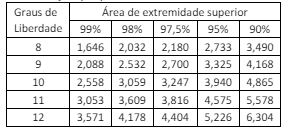
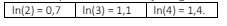Para a resolução da questão, pode ser necessário utilizar alguns dos resultados a seguir.
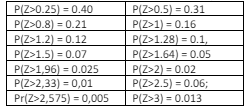
• Probabilidades aproximadas da Normal padrão (Z ~ N(0,1):
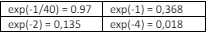
•Valores aproximados da função exponencial:
• Valores aproximados da função logaritmo natural:
Também podem ser úteis os trechos de tabelas das distribuições
a seguir.
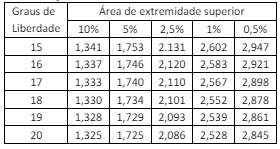
• Distribuição t de Student:
• Distribuição qui-quadrado:
• Distribuição qui-quadrado:
Os tempos Xi de solicitação de resgate de um fundo, por parte dos investidores, seguem distribuição de probabilidade lognormal com parâmetros μ e σ² .Com base em uma amostra aleatória de tamanho n, e considerando “ln” a função logaritmo natural, o estimador consistente para μ, sugerido pela Lei dos Grandes Números, é:
A
B
C
D
E
Revelar gabarito e comentário▾
GabaritoD — [imagem]
Comentário gerado por IA. É um apoio ao estudo, ancorado em fontes, mas pode conter imprecisões — confira sempre na fonte oficial (lei, súmula, edital e gabarito da banca). Encontrou um erro? Use “Reportar”.
Estimador consistente para μ na distribuição lognormal
Gabarito: letra D. Se segue distribuição lognormal com parâmetros e , então segue distribuição normal com média e variância . Pela Lei dos Grandes Números, a média amostral de converge em probabilidade para , de modo que o estimador consistente para é .
A distribuição lognormal é um modelo clássico para variáveis que só assumem valores positivos e que apresentam assimetria à direita, como é o caso dos tempos de solicitação de resgate de um fundo de investimento. A definição formal é: se tem distribuição normal com média e variância , então tem distribuição lognormal com parâmetros e . O parâmetro não é a média de — ele é a média do logaritmo de . Essa distinção é crucial e é exatamente onde a banca arma a pegadinha.
A Lei dos Grandes Números (LGN) é o teorema que garante que a média aritmética de uma amostra aleatória simples converge, em probabilidade, para a esperança matemática da população, à medida que o tamanho da amostra cresce. Formalmente, se são independentes e identicamente distribuídos com , então . A LGN é a justificativa teórica para usar a média amostral como estimador consistente da média populacional.
Aplicando a LGN ao caso da lognormal: como são variáveis aleatórias independentes e identicamente distribuídas com média , a média amostral dos logaritmos converge para . Portanto, o estimador consistente para é a média aritmética dos logaritmos naturais das observações: .
A pegadinha clássica desta questão é confundir o parâmetro da lognormal com a média da própria variável . A média de uma variável lognormal é , que não é igual a . Se o candidato não lembrar dessa relação, pode ser tentado a usar a média aritmética simples de como estimador de , o que estaria errado. A banca explora exatamente essa confusão entre a média da variável original e a média do logaritmo.
Outra armadilha comum é usar o logaritmo da média amostral, , em vez da média dos logaritmos. Embora seja um estimador consistente para (pela continuidade da função logaritmo e pela LGN), ele não é consistente para — ele converge para um valor que inclui . A ordem das operações importa: primeiro aplica-se o logaritmo em cada observação e depois calcula-se a média, não o contrário.
Guarde a distinção central: na lognormal, o parâmetro é a média de , não de . O estimador consistente sugerido pela LGN é a média amostral dos logaritmos. É exatamente esse critério que separa a alternativa correta das demais.
1X ~ lognormal(μ, σ²)
2ln(X) ~ normal(μ, σ²)
3LGN: média amostral → μ
4μ̂ = (1/n) Σ ln(Xᵢ)
LEVEL · soulevel.com.br
Critério
Estimador correto (D)
Armadilha comum: média de X (A)
Armadilha comum: log da média (B)
Fórmula
Converge (LGN) para
Consistente para ?
✅ Sim
❌ Não
❌ Não
Ordem das operações
Logaritmo primeiro, depois média
Nenhum logaritmo
Média primeiro, depois logaritmo
Alternativa A — ❌ Incorreta
Esta alternativa provavelmente apresenta a média aritmética simples como estimador de . Isso está errado porque é um estimador consistente para , não para . A LGN aplicada diretamente a converge para a média de , que não é o parâmetro da lognormal.
Alternativa B — ❌ Incorreta
Esta alternativa provavelmente apresenta , o logaritmo da média amostral. Pela continuidade da função logaritmo e pela LGN, . Portanto, esse estimador é consistente para , não para . A ordem das operações está invertida: deve-se calcular a média dos logaritmos, não o logaritmo da média.
Alternativa C — ❌ Incorreta
Esta alternativa provavelmente apresenta uma expressão envolvendo a soma dos quadrados dos logaritmos, como . Esse estimador converge para , que não é igual a . A LGN aplicada a estima o segundo momento de , não a média.
Alternativa D — ✅ Correta ⟵ GABARITO
Esta alternativa apresenta corretamente , a média aritmética dos logaritmos naturais das observações. Como são i.i.d. com média , a LGN garante que essa média amostral converge em probabilidade para . Este é o estimador consistente sugerido pela LGN.
Alternativa E — ❌ Incorreta
Esta alternativa provavelmente apresenta uma expressão envolvendo a soma dos logaritmos sem dividir por , como . Embora seja o estimador correto, a soma sem a divisão por não converge para — ela diverge para (ou, se normalizada por , converge para , que não é um parâmetro fixo). A LGN exige a média, não a soma.
A regra de ouro para questões de estimação com distribuição lognormal: identifique primeiro qual parâmetro está sendo estimado. Se for , aplique a LGN aos logaritmos das observações. Se for a média de , use a média amostral de . A confusão entre esses dois alvos é a fonte mais comum de erro.