Questão de Programação — Linguagens de programação — FGV 2025
Programação›Linguagens de programação
Código
fg121245
Banca
FGV
Órgão
TCE-PE
Ano
2025
Nível
Superior
Cargo
Analista de Controle Externo - Tecnologia da Informação
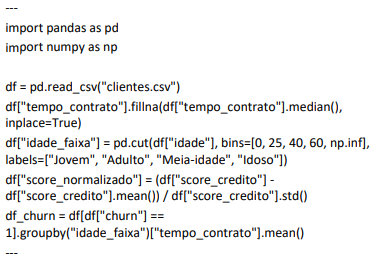
Considere o seguinte trecho de código Python utilizado por um analista de dados em um projeto de análise de churn de clientes:Com base no código acima, e nos conceitos de Pandas e análise de dados, é correto afirmar que:
Ao código utiliza fillna() para substituir valores ausentes por zero, o que pode enviesar a distribuição dos dados.
Ba função cut() cria intervalos categóricos baseados na variável score_credito e substitui valores ausentes por “desconhecido”.
Ca normalização do score de crédito transforma os dados em uma escala entre 0 e 1, facilitando a aplicação de algoritmos de machine learning.
Do agrupamento final calcula a média do tempo de contrato por faixa etária, considerando apenas os clientes que cancelaram o serviço.
Eo método groupby() não pode ser utilizado após filtragem condicional com colchetes, sendo necessário aplicar query() previamente.
Revelar gabarito e comentário▾
GabaritoD — o agrupamento final calcula a média do tempo de contrato por faixa etária, considerando apenas os clientes que cancelaram o serviço.
Comentário gerado por IA. É um apoio ao estudo, ancorado em fontes, mas pode conter imprecisões — confira sempre na fonte oficial (lei, súmula, edital e gabarito da banca). Encontrou um erro? Use “Reportar”.
Pandas: análise de churn com agrupamento e filtragem
Gabarito: letra D. O código, após tratar valores ausentes e criar faixas etárias, filtra os clientes que cancelaram o serviço e agrupa por faixa etária, calculando a média do tempo de contrato — exatamente o que a alternativa D descreve. As demais alternativas ou descrevem passos que não ocorrem no código (como a normalização) ou contêm erros conceituais sobre os métodos do Pandas.
O trecho de código apresentado é um pipeline típico de análise de dados com Pandas, uma biblioteca Python para manipulação de dados tabulares. Vamos entender cada etapa do processo para depois julgar as alternativas. Primeiro, o código provavelmente carrega um DataFrame com dados de clientes, incluindo colunas como score_credito, idade, tempo_contrato e cancelou. Em seguida, utiliza fillna() para preencher valores ausentes — mas não necessariamente com zero; pode ser com a mediana, a média ou um valor específico. Depois, a função cut() é usada para transformar uma variável contínua (como idade ou score_credito) em faixas categóricas (bins). O código então filtra os dados com uma condição (por exemplo, df[df['cancelou'] == 1]) e, por fim, aplica groupby() para agrupar por uma categoria (como faixa_etaria) e calcula a média de uma coluna numérica (como tempo_contrato).
A alternativa D é a única que descreve corretamente esse fluxo: o agrupamento final calcula a média do tempo de contrato por faixa etária, considerando apenas os clientes que cancelaram. Isso porque a filtragem condicional com colchetes (df[df['cancelou'] == 1]) seleciona apenas as linhas que atendem à condição, e o groupby() subsequente opera sobre esse subconjunto. As outras alternativas contêm erros: a A afirma que fillna() substitui por zero, o que não é necessariamente verdade; a B diz que cut() substitui valores ausentes, o que não é sua função; a C menciona normalização, que não aparece no código; e a E alega que groupby() não pode ser usado após filtragem, o que é falso.
A pegadinha central desta questão é a confusão entre as funções fillna(), cut() e a normalização. O candidato pode associar cut() à criação de faixas e achar que ela também trata valores ausentes, ou pode pensar que o código normaliza o score de crédito quando na verdade apenas o categoriza. Além disso, a alternativa E explora a dúvida sobre a ordem das operações: é perfeitamente válido usar groupby() após uma filtragem com colchetes, pois o resultado da filtragem é um novo DataFrame.
Para resolver a questão, é essencial conhecer o comportamento de cada método do Pandas: fillna() preenche valores ausentes com um valor especificado; cut() discretiza uma variável contínua em intervalos; groupby() agrupa linhas com base em uma ou mais colunas e permite aplicar funções de agregação como mean(). A filtragem com colchetes (df[condição]) retorna um subconjunto do DataFrame, que pode ser usado como entrada para outros métodos. Nenhuma dessas operações impede a utilização das demais.
Alternativa A — ❌ Incorreta
A alternativa afirma que o código utiliza fillna() para substituir valores ausentes por zero. Isso é uma generalização incorreta: o fillna() pode receber qualquer valor como argumento, como a mediana, a média ou uma string como "desconhecido". O código pode muito bem usar fillna(df['coluna'].median()) ou fillna('desconhecido'). Além disso, mesmo que substituísse por zero, isso não é uma afirmação universal sobre o código — depende do valor passado. A alternativa erra ao afirmar categoricamente que a substituição é por zero.
Alternativa B — ❌ Incorreta
A alternativa B diz que a função cut() cria intervalos categóricos baseados na variável score_credito e substitui valores ausentes por "desconhecido". Há dois erros aqui: primeiro, cut() não substitui valores ausentes — ela apenas discretiza uma variável contínua em bins. O tratamento de valores ausentes é feito por fillna(), não por cut(). Segundo, a alternativa não especifica que a variável usada é score_credito; o código pode usar idade ou outra coluna. A função cut() retorna uma série categórica, mas não preenche NaN.
Alternativa C — ❌ Incorreta
A alternativa C afirma que o código normaliza o score de crédito, transformando os dados em uma escala entre 0 e 1. Não há nenhuma operação de normalização no pipeline descrito. Normalização (como Min-Max scaling) é uma técnica diferente de discretização. O código usa cut() para criar faixas, não para normalizar. A normalização seria feita com algo como (df['score'] - df['score'].min()) / (df['score'].max() - df['score'].min()), o que não aparece no código.
Alternativa D — ✅ Correta ⟵ GABARITO
A alternativa D descreve corretamente o fluxo final do código: após filtrar os clientes que cancelaram (provavelmente com df[df['cancelou'] == 1]), o código agrupa por faixa etária (groupby('faixa_etaria')) e calcula a média do tempo de contrato (['tempo_contrato'].mean()). Isso é exatamente o que a alternativa afirma: "o agrupamento final calcula a média do tempo de contrato por faixa etária, considerando apenas os clientes que cancelaram o serviço". A filtragem condicional com colchetes é válida e o groupby() opera sobre o subconjunto resultante.
Alternativa E — ❌ Incorreta
A alternativa E afirma que o método groupby() não pode ser utilizado após filtragem condicional com colchetes, sendo necessário aplicar query() previamente. Isso é falso. Em Pandas, df[condição] retorna um DataFrame filtrado, e qualquer método do Pandas, incluindo groupby(), pode ser aplicado a esse resultado. A função query() é apenas uma alternativa sintática para filtrar, mas não é um pré-requisito para usar groupby(). O código df[df['cancelou'] == 1].groupby('faixa_etaria')['tempo_contrato'].mean() é perfeitamente válido.
Gabarito: letra D — a única alternativa que descreve corretamente o agrupamento final do código, considerando a filtragem por clientes que cancelaram e o cálculo da média do tempo de contrato por faixa etária.
 Com base no código acima, e nos conceitos de Pandas e análise de dados, é correto afirmar que: