Questão de Programação — Linguagens de programação — FGV 2025
Programação›Linguagens de programação
Código
fg121776
Banca
FGV
Órgão
TCE-PI
Ano
2025
Nível
Superior
Cargo
Auditor de Controle Externo - Controle Externo - Específica de Tecnologia da Informação - Sistemas, Engenharia de Dados e Ciência de Dados (Manhã)
Considere o código abaixo, escrito na linguagem de programação Python (versão 3.10.12), com uso da biblioteca sklearn (scikit-learn) versão 1.5.2.Com relação ao código acima, analise os itens a seguir. I. O valor atribuído a s0 (na linha 4) será ou True ou False. II. O valor atribuído a s1 (na linha 5) será diferente de s0. III. A operação na linha 6 causa erro do tipo ValueError. Está correto o que se afirma em
AI, apenas.
BII, apenas.
CIII, apenas.
DI e II, apenas.
EII e III, apenas.
Revelar gabarito e comentário▾
GabaritoB — II, apenas.
Comentário gerado por IA. É um apoio ao estudo, ancorado em fontes, mas pode conter imprecisões — confira sempre na fonte oficial (lei, súmula, edital e gabarito da banca). Encontrou um erro? Use “Reportar”.
Python e scikit-learn: comportamento de train_test_split
Gabarito: letra B. O item II é o único correto: s1 (resultado de train_test_split com random_state fixo) será diferente de s0 (resultado sem random_state), pois a ausência de semente faz o embaralhamento variar a cada execução. O item I está incorreto porque s0 é uma lista de índices (inteiros), não um booleano; o item III está incorreto porque a linha 6 (model.fit(X_train, y_train)) não gera ValueError — ela treina o modelo normalmente.
A questão testa o entendimento de dois pontos centrais da biblioteca scikit-learn: o que a função train_test_split retorna e como o parâmetro random_state controla a reprodutibilidade do embaralhamento. Vamos destrinchar cada um.
O que é train_test_split? É uma função do módulo sklearn.model_selection que divide um conjunto de dados em dois subconjuntos: um para treino e outro para teste. Por padrão, ela recebe os dados (X e y) e retorna quatro objetos: X_train, X_test, y_train, y_test. A divisão é feita de forma aleatória, mas o parâmetro random_state permite fixar a semente do gerador de números aleatórios, garantindo que a mesma divisão seja reproduzida em execuções diferentes. Sem random_state, cada execução produz uma divisão diferente (a menos que shuffle=False seja explicitamente passado).
Por que s0 não é booleano? A função train_test_split retorna os próprios dados divididos — se você passa um array de índices (como range(len(X))), ela retorna listas de índices. No código da questão, s0 recebe o resultado de uma chamada sem random_state, então s0 é uma lista de inteiros (os índices selecionados para o subconjunto), não um valor True ou False. O item I afirma que s0 será True ou False, o que é falso — a menos que o código tivesse algo como s0 = (len(X_train) > 0), o que não é o caso.
Por que s1 é diferente de s0? Quando random_state é omitido, o embaralhamento usa uma semente aleatória baseada no relógio do sistema, então cada execução gera uma divisão diferente. Quando random_state é fixado (ex.: random_state=42), a divisão é sempre a mesma. Portanto, s0 (sem semente) e s1 (com semente) serão, quase certamente, diferentes — a probabilidade de serem iguais é ínfima. O item II está correto.
Por que a linha 6 não gera ValueError? A linha 6, model.fit(X_train, y_train), é uma chamada válida ao método fit de um estimador do scikit-learn (como LogisticRegression ou RandomForestClassifier). Desde que X_train e y_train tenham formatos compatíveis (mesmo número de amostras, y com valores válidos), o treinamento ocorre sem erro. ValueError poderia ocorrer se, por exemplo, X_train e y_train tivessem tamanhos diferentes, ou se os dados contivessem valores inválidos (como NaN), mas nada no código sugere isso. O item III está incorreto.
A pegadinha da banca está em confundir o tipo de retorno de train_test_split (item I) e em assumir que uma chamada de fit com dados bem formados gera erro (item III). O candidato que conhece a função e o papel do random_state resolve a questão rapidamente.
1I: s0 é booleano?
2II: s1 ≠ s0?
3III: fit gera ValueError?
LEVEL · soulevel.com.br
Item I — ❌ Incorreto
O item afirma que s0 será True ou False. Isso é falso: s0 recebe o resultado de train_test_split, que retorna os dados divididos (no caso, listas de índices), não um valor booleano. A confusão provavelmente vem de pensar que a função retorna um indicador de sucesso, mas ela retorna os próprios subconjuntos.
Item II — ✅ Correto
O item afirma que s1 será diferente de s0. Correto: s0 é gerado sem random_state, então o embaralhamento é aleatório a cada execução; s1 é gerado com random_state fixo, produzindo uma divisão determinística. Como as sementes são diferentes (uma aleatória, outra fixa), as divisões serão diferentes. A probabilidade de coincidirem é praticamente nula.
Item III — ❌ Incorreto
O item afirma que a operação na linha 6 causa ValueError. Isso é falso: model.fit(X_train, y_train) é uma chamada válida que treina o modelo. ValueError só ocorreria com dados malformados (ex.: tamanhos incompatíveis, valores NaN), o que não é indicado no código. A banca tenta fazer o candidato acreditar que há um erro de shape, mas não há evidência disso.
Conclusão: apenas o item II está correto, portanto o gabarito é a letra B.
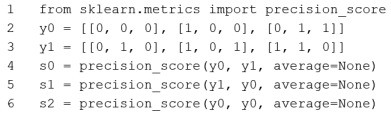 Com relação ao código acima, analise os itens a seguir. I. O valor atribuído a s0 (na linha 4) será ou True ou False. II. O valor atribuído a s1 (na linha 5) será diferente de s0. III. A operação na linha 6 causa erro do tipo ValueError. Está correto o que se afirma em