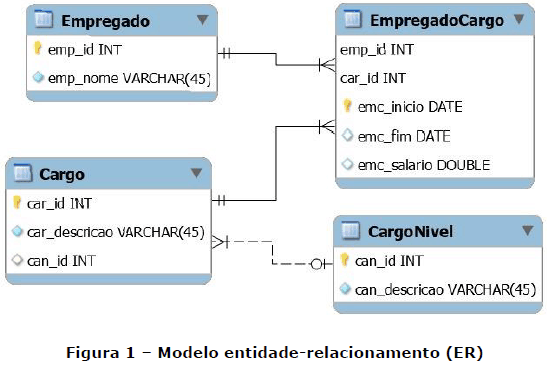
Consultas SQL: último cargo de cada empregado
Gabarito: letra A. Apenas a assertiva I está correta. A consulta I usa uma subconsulta correlacionada para obter a descrição do cargo cuja data de início é a máxima para cada empregado, garantindo que apenas o último cargo seja retornado. As assertivas II e III estão incorretas porque não conseguem isolar corretamente o último cargo de cada empregado, retornando dados incorretos ou duplicados.
O problema central desta questão é a necessidade de, para cada empregado, identificar o registro de empregadocargo com a maior data de início (emc_inicio) e, a partir desse registro, obter a descrição do cargo correspondente. Isso é um clássico problema de "máximo por grupo" em SQL, que pode ser resolvido de várias formas, mas exige cuidado para não retornar cargos antigos ou duplicar informações.
A abordagem mais direta é usar uma subconsulta na cláusula FROM para calcular, para cada emp_id, o valor máximo de emc_inicio. Essa subconsulta cria uma tabela derivada (aliased como sub) com duas colunas: emp_id e emc_inicio (a data máxima). Em seguida, essa tabela derivada é unida à tabela empregadocargo (para obter o car_id correspondente à data máxima) e à tabela empregado (para obter o emp_nome). A subconsulta correlacionada na cláusula SELECT então busca a car_descricao do cargo cujo car_id e emc_inicio correspondem aos valores da linha atual da tabela derivada. Essa é a lógica da assertiva I.
A assertiva II tenta resolver o problema usando GROUP BY emp_nome e MAX(emc_inicio), mas isso é incorreto porque, ao agrupar por emp_nome, a consulta retorna uma linha por empregado, mas a coluna car_descricao não é agregada nem incluída no GROUP BY. Em SQL padrão, isso é um erro de sintaxe (coluna não agregada e não agrupada). Mesmo que o SGBD permitisse (como o MySQL com ONLY_FULL_GROUP_BY desabilitado), o resultado seria imprevisível: a car_descricao retornada não seria necessariamente a do cargo com a data máxima, pois o SGBD escolheria um valor arbitrário do grupo.
A assertiva III usa SELECT DISTINCT e uma subconsulta correlacionada para calcular MAX(emc_inicio) para cada combinação de emp_id e car_id. No entanto, isso não resolve o problema, pois a subconsulta retorna a data máxima para cada cargo individual, não para o empregado como um todo. O resultado incluiria todos os cargos que o empregado já ocupou, cada um com sua própria data máxima, e não apenas o último cargo. Além disso, a cláusula GROUP BY emp_nome é desnecessária e potencialmente conflitante com o SELECT DISTINCT, e a subconsulta correlacionada não está corretamente vinculada à linha externa.
Para entender melhor, considere um exemplo: um empregado com emp_id = 1 ocupou o cargo A (início em 2020) e o cargo B (início em 2022). A assertiva I retornaria apenas o cargo B (o último). A assertiva II retornaria uma linha com emp_nome, car_descricao (arbitrária) e MAX(emc_inicio) = 2022. A assertiva III retornaria duas linhas: uma para o cargo A com data 2020 e outra para o cargo B com data 2022, pois a subconsulta calcula o máximo por cargo, não por empregado.
A pegadinha desta questão está em reconhecer que GROUP BY sozinho não resolve o problema de "último registro por grupo" quando se precisa de outras colunas do registro que contém o máximo. A banca explora a confusão entre agregação simples e a necessidade de uma subconsulta ou junção para obter o registro completo associado ao valor máximo.
Assertiva | Correção | Motivo |
|---|
I | ✅ Correta | Usa subconsulta na cláusula FROM para calcular MAX(emc_inicio) por empregado e subconsulta correlacionada no SELECT para obter a car_descricao do cargo com a data máxima, retornando exatamente o último cargo de cada empregado. |
II | ❌ Incorreta | GROUP BY emp_nome sem agregar car_descricao gera erro de sintaxe em SQL padrão; mesmo se permitido, a descrição retornada seria arbitrária, não necessariamente a do cargo com a data máxima.
|
III | ❌ Incorreta | A subconsulta correlacionada calcula MAX(emc_inicio) por combinação de emp_id e car_id, retornando todos os cargos do empregado (cada um com sua data máxima), e não apenas o último; além disso, a subconsulta referencia tabelas não vinculadas corretamente. |
Assertiva I — ✅ Correta
A consulta I está correta. Ela usa uma subconsulta na cláusula FROM para calcular, para cada emp_id, o valor máximo de emc_inicio. Essa subconsulta é aliased como sub e contém emp_id e emc_inicio. Em seguida, a consulta principal faz um INNER JOIN entre sub e empregado (para obter emp_nome) e usa uma subconsulta correlacionada na cláusula SELECT para obter a car_descricao do cargo cujo car_id e emc_inicio correspondem aos valores da linha atual de sub. A subconsulta correlacionada referencia sub.emp_id e sub.emc_inicio, garantindo que apenas o cargo com a data máxima seja retornado. A consulta também seleciona emc_inicio diretamente da tabela derivada sub, que contém a data máxima. Portanto, a consulta retorna o nome do empregado, a descrição do último cargo e a data de início desse cargo, exatamente como pedido.
Assertiva II — ❌ Incorreta
A assertiva II está incorreta. A consulta usa GROUP BY emp_nome e seleciona car_descricao sem agregá-la. Em SQL padrão, isso é um erro de sintaxe, pois car_descricao não está no GROUP BY nem é usada em uma função de agregação. Mesmo que o SGBD permitisse (com ONLY_FULL_GROUP_BY desabilitado), o resultado seria incorreto: a car_descricao retornada seria arbitrária, não necessariamente a do cargo com a data máxima. Além disso, a consulta retorna MAX(emc_inicio), mas não há garantia de que a car_descricao corresponda a esse máximo. O GROUP BY emp_nome agrupa todas as linhas de um empregado, mas não seleciona o registro específico com a maior data.
Assertiva III — ❌ Incorreta
A assertiva III está incorreta. A consulta usa SELECT DISTINCT e uma subconsulta correlacionada para calcular MAX(emc_inicio) para cada combinação de emp_id e car_id. No entanto, isso retorna a data máxima para cada cargo individual, não para o empregado como um todo. O resultado incluiria todos os cargos que o empregado já ocupou, cada um com sua própria data máxima, e não apenas o último cargo. Além disso, a cláusula GROUP BY emp_nome é desnecessária e potencialmente conflitante com o SELECT DISTINCT, e a subconsulta correlacionada não está corretamente vinculada à linha externa, pois referencia e.emp_id e c.car_id, mas a tabela ec não é usada na subconsulta. A consulta não isola o último cargo de cada empregado.
Gabarito: letra A — apenas a assertiva I está correta.