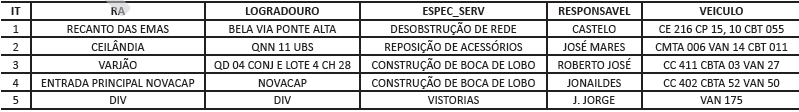
Questão de Banco de Dados — Consultas e Comandos em SQL — Quadrix 2024
Banco de Dados›Consultas e Comandos em SQL
Código
qa630669
Banca
Quadrix
Órgão
NOVACAP
Ano
2024
Cargo
Ana Sis ( )
Com relação à tabela SERVIÇO acima, implementada em um banco de dados relacional, e à linguagem SQL, julgue o item a seguir. Após a execução do comando subsequente SELECT ESPEC_SERV, COUNT(*) FROM SERVICO GROUP BY ESPEC_SERV HAVING COUNT(*) > 1; será mostrada lista a seguir. REPOSIÇÃO DE ACESSÓRIOS CONSTRUÇÃO DE BOCA DE LOBO CONSTRUÇÃO DE BOCA DE LOBO VISTORIAS
CCerto
EErrado
Revelar gabarito e comentário▾
GabaritoE — Errado
Comentário gerado por IA. É um apoio ao estudo, ancorado em fontes, mas pode conter imprecisões — confira sempre na fonte oficial (lei, súmula, edital e gabarito da banca). Encontrou um erro? Use “Reportar”.
SQL: agrupamento com GROUP BY e filtro com HAVING
Gabarito: ERRADO (letra E). A consulta SELECT ESPEC_SERV, COUNT(*) FROM SERVICO GROUP BY ESPEC_SERV HAVING COUNT(*) > 1 agrupa as linhas por especialidade e retorna uma linha por grupo que tenha mais de uma ocorrência — nunca duas linhas com o mesmo valor de ESPEC_SERV. A lista mostrada no enunciado repete "CONSTRUÇÃO DE BOCA DE LOBO" duas vezes, o que é impossível para um GROUP BY, pois cada grupo aparece uma única vez no resultado.
O comando GROUP BY é a cláusula que transforma várias linhas da tabela em grupos, e cada grupo vira uma única linha no resultado. Quando você escreve SELECT ESPEC_SERV, COUNT(*), está pedindo: para cada especialidade distinta, me dê o nome dela e a quantidade de registros que pertencem a ela. O HAVING COUNT(*) > 1 é um filtro que age depois do agrupamento, mantendo apenas os grupos cuja contagem seja maior que 1. Ou seja, o resultado sempre terá valores únicos na coluna ESPEC_SERV — não faz sentido aparecer a mesma especialidade duas vezes, porque ela foi agrupada em um único grupo.
Vamos pensar num exemplo concreto. Suponha que a tabela SERVIÇO tenha estes registros:
ESPEC_SERV
REPOSIÇÃO DE ACESSÓRIOS
REPOSIÇÃO DE ACESSÓRIOS
CONSTRUÇÃO DE BOCA DE LOBO
CONSTRUÇÃO DE BOCA DE LOBO
CONSTRUÇÃO DE BOCA DE LOBO
VISTORIAS
Ao executar a consulta, o GROUP BY ESPEC_SERV cria três grupos: um para "REPOSIÇÃO DE ACESSÓRIOS" (com 2 registros), um para "CONSTRUÇÃO DE BOCA DE LOBO" (com 3 registros) e um para "VISTORIAS" (com 1 registro). O HAVING COUNT(*) > 1 elimina o grupo de "VISTORIAS", pois sua contagem é 1. O resultado final seria:
ESPEC_SERV
COUNT(*)
REPOSIÇÃO DE ACESSÓRIOS
2
CONSTRUÇÃO DE BOCA DE LOBO
3
Perceba: cada especialidade aparece uma única vez, acompanhada da sua contagem. A lista do enunciado mostra "CONSTRUÇÃO DE BOCA DE LOBO" duas vezes e não mostra as contagens — dois erros claros. O primeiro erro é a duplicação de um valor agrupado; o segundo é a ausência da coluna COUNT(*), que é parte obrigatória do SELECT.
A pegadinha aqui é confundir o HAVING com o WHERE. O WHERE filtra linhas antes do agrupamento; o HAVING filtra grupos depois do agrupamento. Se a intenção fosse listar as especialidades que aparecem mais de uma vez, o comando correto seria exatamente o do enunciado — mas o resultado seria uma lista sem repetições, com uma linha por especialidade. A banca tenta fazer o candidato acreditar que o GROUP BY mantém as linhas originais, quando na verdade ele as consolida.
Outro ponto: a ordem de execução lógica do SQL é FROM → WHERE → GROUP BY → HAVING → SELECT → ORDER BY. O HAVING só pode ser usado com funções de agregação (COUNT, SUM, AVG, MAX, MIN) ou com colunas que estejam no GROUP BY. Ele não enxerga linhas individuais — enxerga grupos inteiros. É por isso que a duplicação mostrada no enunciado é logicamente impossível.
Guarde a distinção central: GROUP BY reduz linhas a grupos; cada grupo é uma linha no resultado. Se o resultado mostra a mesma especialidade duas vezes, o comando não foi um GROUP BY — foi um SELECT simples sem agrupamento. É exatamente nessa fronteira que a questão se decide.
Item — ❌ ERRADO ⟵ GABARITO
A lista apresentada está incorreta por dois motivos. Primeiro, o GROUP BY ESPEC_SERV garante que cada especialidade apareça uma única vez no resultado — a repetição de "CONSTRUÇÃO DE BOCA DE LOBO" é impossível. Segundo, o SELECT inclui COUNT(*), então cada linha do resultado deve trazer o nome da especialidade e o número de ocorrências; a lista do enunciado omite as contagens. O resultado correto teria o formato de duas colunas (especialidade e contagem) e uma linha por grupo que passou no filtro do HAVING.
NÃO CAIA NESSA!
A banca explora a confusão entre WHERE e HAVING. O candidato que não domina a ordem de execução do SQL pode achar que o GROUP BY apenas "organiza" as linhas e que o HAVING filtra linhas individuais — mas não é isso. O GROUP BYconsolida linhas em grupos, e o HAVING filtra esses grupos. Se a lista mostra a mesma especialidade duas vezes, ela não poderia ter vindo de um GROUP BY. Fique atento: sempre que o resultado de uma consulta com GROUP BY repetir um valor da coluna agrupada, desconfie — é sinal de que a consulta foi mal interpretada.
PEGA ESSA DICA!
Para resolver questões de GROUP BY/HAVING na prova, siga a ordem lógica do SQL: primeiro o FROM (de onde vêm os dados), depois o WHERE (filtra linhas), depois o GROUP BY (agrupa), depois o HAVING (filtra grupos) e só então o SELECT (projeta colunas). Pergunte-se: "quantas linhas o resultado terá?" — a resposta é sempre o número de grupos que passaram no HAVING, nunca o número de linhas originais. Se a questão mostrar um resultado com repetição de valores agrupados, está errada.