Para responder à questão, considere um banco de dados PostgreSQL no qual um
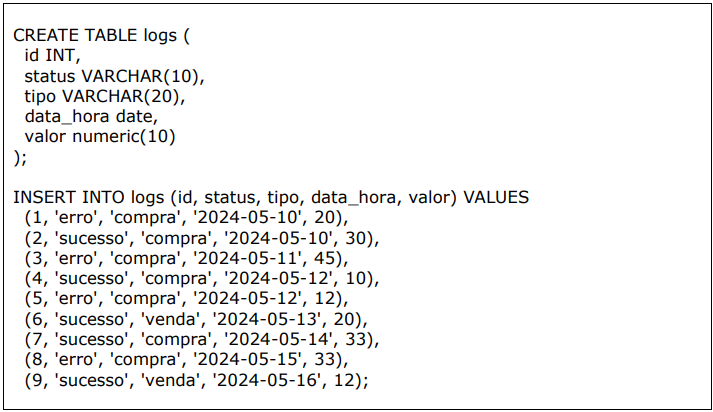
analista de sistemas executou, com sucesso, os comandos SQL abaixo:
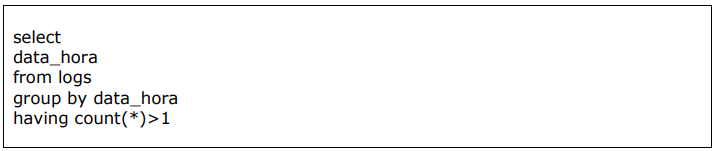
O analista executou o seguinte comando SQL:Quantos registros a execução desse comando SQL retornou?
A1.
B2.
C3.
D4.
E5.
Revelar gabarito e comentário▾
GabaritoB — 2.
Comentário gerado por IA. É um apoio ao estudo, ancorado em fontes, mas pode conter imprecisões — confira sempre na fonte oficial (lei, súmula, edital e gabarito da banca). Encontrou um erro? Use “Reportar”.
Resolução
Gabarito: letra B — a conta chega a 2 registros — alternativa B.
A ideia por trás
Em SQL, uma consulta de agregação agrupa linhas que têm o mesmo valor em uma coluna e calcula um resumo para cada grupo. A cláusula GROUP BY define o critério de agrupamento, e funções como COUNT, SUM ou AVG resumem cada grupo em uma única linha de resultado.
A cláusula HAVING filtra os grupos DEPOIS de agrupados, usando condições sobre as funções de agregação. Já o WHERE filtra linhas individuais ANTES do agrupamento. Por isso, HAVING é o único lugar onde se pode escrever COUNT(*) > 1. O resultado da consulta é uma linha por grupo que passa no filtro.
Esta questão testa exatamente essa diferença: é preciso contar quantos grupos têm mais de uma ocorrência, ignorando os grupos com apenas uma linha.
O que a questão dá
tabela familia com coluna relação
comando: SELECT relação, sum(1) FROM familia GROUP BY relação HAVING count(*) > 1
O que queremos: quantos registros a consulta retorna
Passo 1 — Listar os valores da coluna relação
Para saber quantos grupos existem e quantas linhas cada um tem, precisamos primeiro ver os dados da tabela. O GROUP BY vai juntar as linhas com o mesmo valor.
NÃO CAIA NESSA!
Esquecer de contar todas as ocorrências de cada valor.
Passo 2 — Agrupar e contar as ocorrências
O GROUP BY relação cria um grupo para cada valor distinto. A função sum(1) conta quantas linhas há em cada grupo, equivalente a count(*).
Por que esta fórmula: sum(1) soma o número 1 para cada linha do grupo, resultando na contagem de linhas. É uma forma alternativa de count(*).
De onde vem cada valor: = definição: contagem de linhas do grupo · = enunciado: função sum(1) do comando
NÃO CAIA NESSA!
Confundir sum(1) com soma de valores de uma coluna; aqui é contagem.
Passo 3 — Filtrar grupos com mais de uma ocorrência
O HAVING count(*) > 1 descarta os grupos que têm apenas 1 linha. Isso é feito após o agrupamento, então só os grupos com contagem maior que 1 permanecem.
Por que esta fórmula: HAVING é a cláusula que filtra grupos, e a condição usa a função de agregação count(*).
De onde vem cada valor: = passo 2: contagem de cada grupo
NÃO CAIA NESSA!
Usar WHERE count(*) > 1, que é inválido porque WHERE não aceita funções de agregação.
 Quantos registros a execução desse comando SQL retornou?