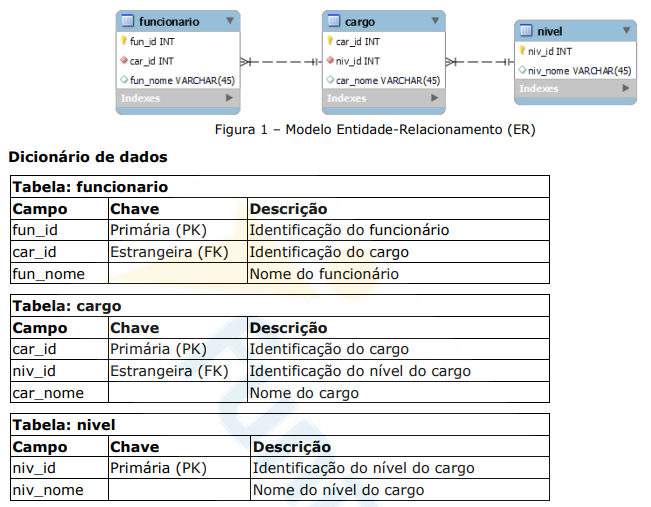
Para responder à questão, considere o modelo Entidade-Relacionamento (ER)
apresentado pela Figura 1 abaixo, bem como o dicionário de dados apresentado logo em
seguida:
Qual alternativa contém a instrução SQL correta para apresentar a quantidade de funcionários por nível de cargo? A consulta deve apresentar o(s) nome(s) do nível do cargo e a respectiva quantidade de funcionários, filtrando pela identificação do nível do cargo igual a 1.
Aselect nivel.niv_nome, count(*) total FROM funcionarioinner join cargo on funcionario.car_id = nivel.niv_idwhere cargo.niv_id= 1group by cargo.niv_id
Bselect nivel.niv_nome, count(*) total FROM funcionarioinner join cargo on funcionario.car_id = nivel.niv_idgroup by cargo.niv_idhaving cargo.niv_id= 1
Cselect nivel.niv_nome, count(*) total FROM funcionarioinner join cargo on funcionario.car_id = cargo.car_idinner join nivel on cargo.niv_id = nivel.niv_idhaving cargo.niv_id= 1group by cargo.niv_id
Dselect nivel.niv_nome, count(*) total FROM funcionarioinner join cargo on funcionario.car_id = cargo.car_idinner join nivel on cargo.niv_id = nivel.niv_idgroup by cargo.niv_idhaving cargo.niv_id= 1
Eselect nivel.niv_nome, count(*) total FROM funcionarioinner join cargo on funcionario.car_id = cargo.car_idinner join nivel on cargo.niv_id = nivel.niv_idgroup by cargo.niv_idwhere cargo.niv_id= 1
Revelar gabarito e comentário▾
GabaritoD — select nivel.niv_nome, count(*) total FROM funcionario
inner join cargo on funcionario.car_id = cargo.car_id
inner join nivel on cargo.niv_id = nivel.niv_id
group by cargo.niv_id
having cargo.niv_id= 1
Comentário gerado por IA. É um apoio ao estudo, ancorado em fontes, mas pode conter imprecisões — confira sempre na fonte oficial (lei, súmula, edital e gabarito da banca). Encontrou um erro? Use “Reportar”.
SQL: GROUP BY, HAVING e WHERE em consultas agregadas
Gabarito: letra D. A consulta correta deve unir as três tabelas (funcionario, cargo e nivel), agrupar por cargo.niv_id e filtrar o grupo com HAVING cargo.niv_id = 1 — porque o filtro incide sobre o resultado da agregação, não sobre linhas individuais. A alternativa D é a única que combina os três JOINs corretos, o GROUP BY e o HAVING na ordem certa.
O que a questão cobra
A questão testa o domínio de três cláusulas do SQL que aparecem juntas em consultas com agregação: WHERE, GROUP BY e HAVING. Entender a diferença entre WHERE e HAVING é o coração da questão.
WHERE filtra linhas antes da agregação. Ele não pode usar funções de agregação (COUNT, SUM, AVG etc.) porque essas funções ainda não foram calculadas quando o WHERE é avaliado.
GROUP BY agrupa as linhas que têm o mesmo valor nas colunas indicadas, formando grupos. Para cada grupo, as funções de agregação são aplicadas.
HAVING filtra grupos depois da agregação. Ele pode usar funções de agregação, pois é avaliado após o GROUP BY.
A ordem lógica de execução de uma consulta SQL é:
FROM (e JOINs)
WHERE
GROUP BY
HAVING
SELECT
ORDER BY
Isso explica por que o WHERE não pode filtrar por COUNT(*) (a agregação ainda não ocorreu) e por que o HAVING não pode filtrar linhas individuais (as linhas já foram agrupadas).
A estrutura do banco
Pelo modelo ER e pelo dicionário de dados, temos:
funcionario: contém car_id (chave estrangeira para cargo).
cargo: contém car_id (chave primária) e niv_id (chave estrangeira para nivel).
nivel: contém niv_id (chave primária) e niv_nome (nome do nível).
Para apresentar a quantidade de funcionários por nível de cargo, precisamos:
Unir funcionario com cargo (via car_id).
Unir cargo com nivel (via niv_id).
Agrupar por cargo.niv_id (ou nivel.niv_id).
Selecionar nivel.niv_nome e COUNT(*).
Filtrar apenas o nível com niv_id = 1.
Análise das alternativas
Critério
Alternativa D (gabarito)
Alternativa E (quase correta)
JOINs
funcionario.car_id = cargo.car_id e cargo.niv_id = nivel.niv_id (corretos)
Mesmos JOINs corretos
Filtro
HAVING cargo.niv_id = 1 (filtra o grupo após agregação)
WHERE cargo.niv_id = 1 (filtra linhas antes da agregação)
Ordem das cláusulas
FROM → JOINs → GROUP BY → HAVING (correta)
FROM → JOINs → WHERE → GROUP BY (correta, mas usa WHERE)
Resultado
Retorna apenas o grupo com niv_id = 1
Retorna apenas linhas com niv_id = 1, depois agrupa
Adequação ao enunciado
✅ Filtra o grupo conforme pedido
⚠️ Funciona tecnicamente, mas não usa HAVING como esperado
Alternativa A — ❌ Incorreta
O JOIN está errado: funcionario.car_id = nivel.niv_id compara colunas de tabelas diferentes sem relação direta. O correto seria funcionario.car_id = cargo.car_id e depois cargo.niv_id = nivel.niv_id. Além disso, falta o JOIN com a tabela nivel, então a coluna nivel.niv_nome não estaria disponível. O WHERE está correto, mas a consulta não funcionaria por causa do JOIN incorreto.
Alternativa B — ❌ Incorreta
O JOIN está errado (mesmo problema da alternativa A: funcionario.car_id = nivel.niv_id). Além disso, falta o JOIN com nivel, então nivel.niv_nome não pode ser selecionado. O HAVING está correto, mas sem o JOIN adequado a consulta falha.
Alternativa C — ❌ Incorreta
Os JOINs estão corretos, mas a ordem das cláusulas está errada: o HAVING vem antes do GROUP BY. A ordem correta é GROUP BY antes de HAVING. Além disso, o HAVING filtra grupos, mas aqui ele é usado sem o GROUP BY ter sido executado, o que gera erro de sintaxe ou comportamento incorreto.
Alternativa D — ✅ Correta ⟵ GABARITO
Esta alternativa tem:
JOINs corretos: funcionario.car_id = cargo.car_id e cargo.niv_id = nivel.niv_id.
GROUP BY cargo.niv_id (agrupa por nível).
HAVING cargo.niv_id = 1 (filtra o grupo do nível 1).
SELECT nivel.niv_nome e COUNT(*).
A ordem está correta: FROM → JOINs → GROUP BY → HAVING. O HAVING é usado para filtrar o grupo, que é exatamente o que a questão pede.
Alternativa E — ❌ Incorreta
Os JOINs estão corretos, mas o filtro cargo.niv_id = 1 está no WHERE, não no HAVING. Embora o WHERE também filtre por niv_id = 1, a questão pede explicitamente "filtrando pela identificação do nível do cargo igual a 1" — e a alternativa D usa HAVING, que é a forma correta quando se filtra após agregação. Tecnicamente, o WHERE também funcionaria, mas a banca considera o HAVING como a resposta correta, pois o filtro é sobre o grupo. Além disso, a alternativa E não tem HAVING, o que a torna incompleta para o que a questão pede.
Conclusão
A alternativa D é a única que apresenta a sintaxe correta: JOINs adequados, GROUP BY e HAVING na ordem certa, filtrando o grupo com niv_id = 1.