Questão de Banco de Dados — Modelagem de dados — FUNDATEC 2025
Banco de Dados›Modelagem de dados
Código
qg474973
Banca
FUNDATEC
Órgão
PROCERGS
Ano
2025
Nível
Superior
Cargo
Analista em Computação/Ênfase em Programação de Sistemas na Tecnologia Microsoft
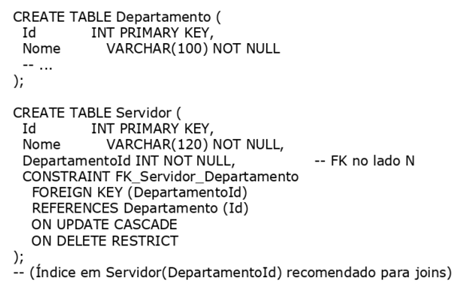
Um órgão federal modelou a relação Departamento-Servidor como um-para-muitos (1:N): cada Servidor pertence a um único Departamento, e um Departamento pode ter muitos Servidores. Não há histórico de lotações (cada servidor tem no máximo uma lotação vigente) ea relação não possui atributos próprios além das chaves. A título ilustrativo, o desenho esperado é compatível como o seguinte DDL:No banco relacional, qual é a implementação usual e correta para esse mapeamento?
ATornar obrigatória uma tabela associativa (por exemplo, DepartamentoServidor), mesmo sem atributos na relação, para "garantir escalabilidade futura".
BDefinir chave estrangeira nos dois lados (Departamento → Servidor e Servidor → Departamento), assegurando referência circular para maior integridade.
CColocar a chave estrangeira no lado N usando nulidade para refletir opcionalidade e índice para joins eficientes.
DManter, no lado 1, uma coluna com lista de identificadores dos servidores para "evitar joins".
ECriar uma tabela de junção sem atributos com chave estrangeira opcional, deixando as tabelas principais sem referência direta.
Revelar gabarito e comentário▾
GabaritoC — Colocar a chave estrangeira no lado N usando nulidade para refletir opcionalidade e índice para joins eficientes.
Comentário gerado por IA. É um apoio ao estudo, ancorado em fontes, mas pode conter imprecisões — confira sempre na fonte oficial (lei, súmula, edital e gabarito da banca). Encontrou um erro? Use “Reportar”.
Mapeamento de relacionamento 1:N no modelo relacional
Gabarito: letra C. Em um relacionamento um-para-muitos (1:N), a implementação usual e correta no banco relacional é colocar a chave estrangeira no lado N (no caso, na tabela Servidor), permitindo valores nulos para refletir a opcionalidade (um servidor pode ainda não ter departamento) e criando índice sobre essa coluna para acelerar as junções (joins). Essa é a regra clássica de mapeamento de cardinalidades, presente em qualquer livro de modelagem de dados (Elmasri & Navathe, Heuser).
O relacionamento 1:N entre Departamento e Servidor significa que cada Servidor pertence a exatamente um Departamento (ou, se opcional, a no máximo um), e cada Departamento pode ter vários Servidores. No modelo relacional, isso é representado adicionando à tabela do lado N (Servidor) uma coluna que referencia a chave primária da tabela do lado 1 (Departamento). Essa coluna é a chave estrangeira (FK). Ela pode ser definida como NOT NULL (se todo servidor deve ter departamento) ou permitir nulos (se a lotação é opcional). O enunciado diz que "cada servidor tem no máximo uma lotação vigente", o que sugere que pode haver servidor sem lotação, ou seja, a FK deve ser opcional (nullable). Além disso, criar um índice sobre a coluna da chave estrangeira é uma prática recomendada para acelerar as operações de junção (JOIN) entre as tabelas, pois o SGBD pode localizar rapidamente os servidores de um departamento.
A alternativa C captura exatamente isso: "Colocar a chave estrangeira no lado N usando nulidade para refletir opcionalidade e índice para joins eficientes." É a implementação canônica.
Vamos entender por que as demais estão erradas:
A) Criar uma tabela associativa (tabela de junção) é necessário apenas para relacionamentos muitos-para-muitos (N:M). Para 1:N, ela é desnecessária e adiciona complexidade sem benefício, pois a chave estrangeira no lado N já resolve o mapeamento.
B) Colocar chave estrangeira nos dois lados criaria uma referência circular e redundante. No lado 1 (Departamento), não faz sentido ter uma FK para Servidor, pois um departamento pode ter muitos servidores; não há como armazenar essa relação em uma única coluna sem violar a 1FN (atributo multivalorado). A integridade referencial é garantida pela FK no lado N, não por referência circular.
D) Manter uma lista de identificadores de servidores na tabela Departamento viola a primeira forma normal (1FN), que exige atributos atômicos. Além disso, essa abordagem dificulta consultas e manutenção, e não é a forma relacional correta.
E) Criar uma tabela de junção sem atributos para um relacionamento 1:N é redundante e desnecessária, como na alternativa A. Além disso, deixar as tabelas principais sem referência direta quebraria a integridade referencial e complicaria o acesso aos dados.
A pegadinha da banca está em confundir o mapeamento de 1:N com o de N:M. Muitos candidatos, ao verem a palavra "relação", pensam automaticamente em tabela de junção, mas ela só é necessária para N:M. Para 1:N, a chave estrangeira no lado N é a solução padrão.
Critério
1:N (gabarito C)
N:M (tabela associativa)
Onde fica a FK
No lado N (Servidor → Departamento)
Em tabela própria de junção (ex.: DepartamentoServidor)
Atributos da relação
Não há tabela extra; FK simples no lado N
Tabela associativa pode ter atributos próprios (ex.: data de início)
Nulidade da FK
Usada para refletir opcionalidade (ex.: servidor sem lotação)
Geralmente NOT NULL nas duas FKs (participação total)
Índice
Recomendado índice sobre a FK no lado N
Índices nas duas FKs da tabela de junção
Quando usar
Relacionamento 1:N (um departamento → muitos servidores)
Relacionamento N:M (ex.: servidor ↔ projeto)
Alternativa A — ❌ Incorreta
A tabela associativa (também chamada de tabela de ligação ou junção) é a solução para relacionamentos muitos-para-muitos (N:M), não para 1:N. Em 1:N, a chave estrangeira no lado N já representa o relacionamento sem necessidade de tabela extra. Criar uma tabela associativa sem atributos adicionaria uma camada desnecessária, aumentando a complexidade e o número de joins sem nenhum benefício. A justificativa de "garantir escalabilidade futura" não se sustenta: se no futuro o relacionamento mudar para N:M, aí sim a tabela associativa seria criada, mas não se projeta um banco para um futuro hipotético em detrimento da modelagem correta atual.
Alternativa B — ❌ Incorreta
Definir chave estrangeira nos dois lados criaria uma referência circular e redundante. No lado 1 (Departamento), não é possível armazenar a referência a vários servidores em uma única coluna sem violar a atomicidade (1FN). A integridade referencial é garantida pela chave estrangeira no lado N (Servidor → Departamento), que assegura que todo servidor pertença a um departamento existente. Referência circular não aumenta a integridade; pelo contrário, pode causar problemas de inserção e manutenção (qual inserir primeiro?).
Alternativa C — ✅ Correta ⟵ GABARITO
Esta é a implementação clássica e correta. A chave estrangeira (FK) é adicionada à tabela do lado N (Servidor), referenciando a chave primária da tabela do lado 1 (Departamento). A nulidade da FK reflete a opcionalidade do relacionamento: se um servidor pode ainda não ter departamento, a coluna aceita NULL; se for obrigatório, define-se NOT NULL. Além disso, criar um índice sobre a coluna da FK é uma prática recomendada para acelerar as operações de junção (JOIN), pois o SGBD pode localizar rapidamente os registros relacionados. Essa abordagem é simples, eficiente e respeita as formas normais.
Alternativa D — ❌ Incorreta
Manter uma coluna com lista de identificadores de servidores na tabela Departamento viola a primeira forma normal (1FN), que exige que todos os atributos sejam atômicos (não multivalorados). Uma lista de IDs é um atributo multivalorado, o que impossibilita consultas eficientes e viola os princípios do modelo relacional. Além disso, essa abordagem dificulta a manutenção da integridade referencial e a realização de joins. A forma correta é a chave estrangeira no lado N.
Alternativa E — ❌ Incorreta
Criar uma tabela de junção sem atributos para um relacionamento 1:N é redundante e desnecessária, como na alternativa A. Além disso, deixar as tabelas principais sem referência direta quebraria a integridade referencial e complicaria o acesso aos dados. A tabela de junção só é necessária para relacionamentos N:M. Em 1:N, a chave estrangeira no lado N é a solução padrão e mais eficiente.
NÃO CAIA NESSA!
A banca tenta confundir o mapeamento de 1:N com o de N:M. A tabela associativa (alternativas A e E) é a solução para N:M, não para 1:N. Lembre-se: 1:N → chave estrangeira no lado N; N:M → tabela de ligação. Essa é a regra de ouro que separa as alternativas.
PEGA ESSA DICA!
Na hora da prova, identifique a cardinalidade e aplique a regra: se for 1:N, a FK fica na tabela do lado N (a que representa a entidade que "pertence a" uma da outra). Se for N:M, crie uma tabela associativa com as duas chaves estrangeiras. Essa distinção resolve a maioria das questões de mapeamento.
 No banco relacional, qual é a implementação usual e correta para esse mapeamento?