Manipulação de Dados com Pandas
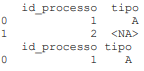
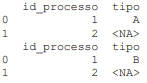
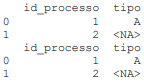
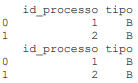
Gabarito: letra E. O método dropna() do Pandas, quando chamado sem o parâmetro inplace=True, retorna uma nova cópia do DataFrame sem as linhas que contêm valores ausentes (NaN/pd.NA), mas não altera o objeto original. Portanto, a primeira chamada df.dropna() não modifica df. Após a atribuição df.loc[1, 'tipo'] = 'B', o valor ausente na linha de índice 1 é substituído por 'B'. A segunda chamada df.dropna(inplace=True) altera o DataFrame original, mas como não há mais valores ausentes, o DataFrame permanece inalterado.
O código realiza as seguintes etapas:
Criação do DataFrame: O DataFrame df é inicializado com duas linhas. A linha 0 tem tipo='A' e a linha 1 tem tipo=pd.NA.
Primeira chamada df.dropna(): Como não foi utilizado inplace=True, o resultado é descartado. O DataFrame df permanece com o valor ausente na linha 1.
Atribuição: df.loc[1, 'tipo'] = 'B' altera o valor da linha 1, coluna 'tipo', de pd.NA para 'B'.
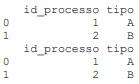
Primeiro print(df.to_string()): Exibe o estado atual do DataFrame, onde a linha 0 é 'A' e a linha 1 é 'B'.
Segunda chamada df.dropna(inplace=True): Esta operação busca remover linhas com valores ausentes. Como o DataFrame não possui mais pd.NA, nada é removido.
Segundo print(df.to_string()): Exibe o estado final do DataFrame, que é idêntico ao anterior.
Alternativa E — ✅ Correta ⟵ GABARITO
Esta alternativa apresenta corretamente o resultado das duas impressões. Na primeira, o DataFrame já contém 'A' e 'B' (após a atribuição). Na segunda, como o dropna não encontrou valores nulos para remover, o DataFrame permanece inalterado, exibindo o mesmo conteúdo.
Alternativas A, B, C e D — ❌ Incorretas
Estas alternativas falham ao representar o estado do DataFrame após a atribuição do valor 'B' ou ao interpretar incorretamente o comportamento do método dropna sem o parâmetro inplace ou com ele aplicado a um DataFrame que já não continha valores nulos.