Questão de Banco de Dados — Modelagem e Mapeamento ER-relacional — FGV 2025
Banco de Dados›Modelagem e Mapeamento ER-relacional
Código
fg169069
Banca
FGV
Órgão
MPU
Ano
2025
Cargo
Ana
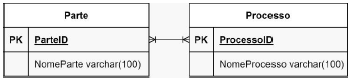
Observe o modelo de dados, que utiliza a Notação Crow's Foot (Pé de Galinha), onde PK representa a Chave Primária: Após a normalização, no PostgreSQL, para implementar o modelo de dados físico com as integridades referenciais, deve-se executar o seguinte script SQL:
ACREATE TABLE Processo ( ProcessoID SERIAL PRIMARY KEY, NomeProcesso VARCHAR(100)); CREATE TABLE Parte ( ParteID SERIAL PRIMARY KEY, NomeParte VARCHAR(100)); CREATE TABLE ProcessoParte ( ProcessoID INTEGER REFERENCES Processo(ProcessoID), ParteID INTEGER REFERENCES Parte(ParteID), PRIMARY KEY (ProcessoID, ParteID));
BCREATE TABLE Processo ( ProcessoID SERIAL UNIQUE, NomeProcesso VARCHAR(100)); CREATE TABLE Parte ( ParteID SERIAL UNIQUE, NomeParte VARCHAR(100)); CREATE TABLE ProcessoParte ( ProcessoID SERIAL UNIQUE, ParteID SERIAL UNIQUE );
CCREATE TABLE Processo ( ProcessoID SERIAL NOT NULL, NomeProcesso VARCHAR(100)); CREATE TABLE Parte ( ParteID SERIAL NOT NULL, NomeParte VARCHAR(100)); CREATE TABLE ProcessoParte ( UNIQUE (ProcessoID, ParteID));
ECREATE TABLE ProcessoParte ( FOREIGN KEY(ProcessoID NOT NULL,ParteID NOT NULL), NomeParte VARCHAR(100), NomeProcesso VARCHAR(100));
Revelar gabarito e comentário▾
GabaritoA — CREATE TABLE Processo (
ProcessoID SERIAL PRIMARY KEY,
NomeProcesso VARCHAR(100));
CREATE TABLE Parte (
ParteID SERIAL PRIMARY KEY,
NomeParte VARCHAR(100));
CREATE TABLE ProcessoParte (
ProcessoID INTEGER REFERENCES Processo(ProcessoID),
ParteID INTEGER REFERENCES Parte(ParteID),
PRIMARY KEY (ProcessoID, ParteID));
Comentário gerado por IA. É um apoio ao estudo, ancorado em fontes, mas pode conter imprecisões — confira sempre na fonte oficial (lei, súmula, edital e gabarito da banca). Encontrou um erro? Use “Reportar”.
Mapeamento ER para Relacional e Integridade Referencial no PostgreSQL
Gabarito: letra A. O script correto cria as tabelas Processo e Parte com chaves primárias (SERIAL PRIMARY KEY) e a tabela associativa ProcessoParte com chave primária composta (ProcessoID, ParteID) e chaves estrangeiras referenciando as tabelas originais — exatamente o que a notação Crow's Foot de um relacionamento muitos-para-muitos (N:N) exige após a normalização. As demais alternativas erram ao omitir a chave primária, usar UNIQUE no lugar de PRIMARY KEY, ou declarar chaves estrangeiras de forma sintaticamente inválida no PostgreSQL.
O modelo apresentado na notação Crow's Foot mostra duas entidades, Processo e Parte, ligadas por um relacionamento muitos-para-muitos (N:N). No modelo relacional, um relacionamento N:N não pode ser representado diretamente: é necessário criar uma tabela associativa (também chamada de tabela de junção ou tabela de ligação) que armazene as chaves primárias das duas entidades envolvidas. Essa tabela associativa terá uma chave primária composta pelas duas chaves estrangeiras, garantindo que cada par (Processo, Parte) seja único.
A normalização aqui se refere à aplicação das formas normais, em especial a eliminação de redundâncias e a garantia de que cada tabela represente um único conceito. No modelo físico, isso se traduz em:
Tabela Processo: com ProcessoID como chave primária (identifica unicamente cada processo) e NomeProcesso.
Tabela Parte: com ParteID como chave primária e NomeParte.
Tabela ProcessoParte: com ProcessoID e ParteID como chaves estrangeiras, e a chave primária composta (ProcessoID, ParteID).
A integridade referencial é implementada no PostgreSQL através da cláusula REFERENCES, que garante que um valor de chave estrangeira em ProcessoParte só possa existir se houver um valor correspondente na tabela referenciada. Isso impede, por exemplo, que um registro em ProcessoParte aponte para um ProcessoID inexistente.
Um exemplo prático: se houver um processo "Ação Trabalhista 001" e uma parte "João da Silva", a tabela ProcessoParte pode conter o par (1, 1), indicando que João é parte no processo. Se tentarmos inserir (2, 1) sem que exista o processo 2, o PostgreSQL rejeitará a operação, pois violaria a integridade referencial.
A pegadinha central desta questão é a distinção entre PRIMARY KEY e UNIQUE. Enquanto PRIMARY KEY define a chave primária (que é única e não nula), UNIQUE apenas garante unicidade, mas não define a chave primária da tabela. Além disso, a alternativa B usa SERIAL UNIQUE nas colunas da tabela associativa, o que criaria chaves independentes e não uma chave composta, quebrando a semântica do relacionamento N:N.
Guarde o critério decisivo: em um relacionamento N:N, a tabela associativa deve ter chave primária composta pelas chaves estrangeiras das duas entidades, e cada chave estrangeira deve ser declarada com REFERENCES. É exatamente esse padrão que separa a alternativa correta das demais.
Critério
Alternativa A (✅ correta)
Alternativa B (❌)
Alternativa C (❌)
Alternativa D (❌)
Alternativa E (❌)
Chave primária em Processo/Parte
SERIAL PRIMARY KEY em ambas
SERIAL UNIQUE (sem PK formal)
SERIAL NOT NULL (sem PK)
Não cria tabelas Processo/Parte
Não cria tabelas Processo/Parte
Chave primária composta em ProcessoParte
PRIMARY KEY (ProcessoID, ParteID)
Ausente (colunas independentes)
Apenas UNIQUE (ProcessoID, ParteID)
Ausente
Ausente
Integridade referencial (REFERENCES)
Presente em ambas as FKs
Ausente
Ausente
Sintaxe inválida (FOREIGN KEY sem REFERENCES)
Sintaxe inválida (FOREIGN KEY com NOT NULL dentro)
Normalização (sem atributos desnecessários)
✅ Apenas FKs na tabela associativa
✅ Apenas FKs, mas sem PK/FK corretas
✅ Apenas FKs, mas sem PK/FK corretas
❌ Inclui NomeParte/NomeProcesso
❌ Inclui NomeParte/NomeProcesso
Alternativa A — ✅ Correta ⟵ GABARITO
Esta alternativa implementa corretamente o modelo:
Processo e Parte com SERIAL PRIMARY KEY — cada uma com sua chave primária.
ProcessoParte com ProcessoID INTEGER REFERENCES Processo(ProcessoID) e ParteID INTEGER REFERENCES Parte(ParteID) — chaves estrangeiras com integridade referencial.
PRIMARY KEY (ProcessoID, ParteID) — chave primária composta, garantindo unicidade do par e implementando corretamente o relacionamento N:N.
Alternativa B — ❌ Incorreta
Usa SERIAL UNIQUE em vez de SERIAL PRIMARY KEY. UNIQUE garante unicidade, mas não define a chave primária da tabela. Além disso, na tabela ProcessoParte, as colunas são declaradas como SERIAL UNIQUE independentes, sem chave primária composta e sem REFERENCES — ou seja, não há integridade referencial e o relacionamento N:N não é implementado corretamente.
Alternativa C — ❌ Incorreta
Declara ProcessoID SERIAL NOT NULL e ParteID SERIAL NOT NULL, mas não define chave primária em nenhuma das tabelas. A tabela ProcessoParte tem apenas UNIQUE (ProcessoID, ParteID), que garante unicidade do par, mas não há REFERENCES para as tabelas Processo e Parte, violando a integridade referencial. Além disso, sem PRIMARY KEY, as tabelas Processo e Parte não têm identificador único formal.
Alternativa D — ❌ Incorreta
A sintaxe ProcessoID FOREIGN KEY é inválida no PostgreSQL. A declaração correta de uma chave estrangeira exige a cláusula REFERENCES (ex.: ProcessoID INTEGER REFERENCES Processo(ProcessoID)). Além disso, a tabela ProcessoParte não possui chave primária e mistura atributos das outras entidades (NomeParte, NomeProcesso), o que viola a normalização.
Alternativa E — ❌ Incorreta
A sintaxe FOREIGN KEY(ProcessoID NOT NULL, ParteID NOT NULL) é inválida. A cláusula FOREIGN KEY deve ser seguida da lista de colunas e da referência (REFERENCES), e a restrição NOT NULL não é declarada dessa forma dentro de FOREIGN KEY. Além disso, a tabela não possui chave primária e inclui atributos desnecessários (NomeParte, NomeProcesso), quebrando a normalização.
NÃO CAIA NESSA!
A banca explora a confusão entre PRIMARY KEY e UNIQUE. Muitos candidatos acham que UNIQUE é suficiente para definir a chave primária, mas não é: PRIMARY KEY é a chave que identifica a linha, enquanto UNIQUE apenas impede duplicatas. Além disso, a sintaxe de FOREIGN KEY no PostgreSQL exige REFERENCES, e qualquer alternativa que omita isso está incorreta.
PEGA ESSA DICA!
Para mapear um relacionamento N:N, siga sempre o padrão: crie as duas tabelas originais com PRIMARY KEY, depois crie a tabela associativa com as chaves estrangeiras (REFERENCES) e a chave primária composta. Na prova, desconfie de alternativas que usem UNIQUE no lugar de PRIMARY KEY ou que declarem chaves estrangeiras sem REFERENCES.